ComfyUI 生图实战
笔记 / AI 原理
ComfyUI 把生图从「填表单点按钮」变成「搭数据流图」:每个节点是一次张量变换,连线就是张量的流动。这个抽象换来三样东西——工作流本身即是文档、复现单位和分享格式(一张 PNG、一个 JSON 就是完整的可执行配置)。代价是学习曲线:没有任何预设「模式」,txt2img 和 img2img 的区别只是一条连线和 denoise 的取值。扩散模型的数学原理见 扩散模型,本文只讲怎么把它跑起来。本分类全部笔记见 AI 原理。
一、安装与模型目录
官方现在有三种发行形态,按需选:
- 桌面版(Comfy Desktop):Windows / macOS(Apple Silicon)/ Linux(AppImage 或 .deb),默认跟随 stable 发布,适合不想碰命令行的人
- Windows 便携包(Portable):自带独立 Python 环境,解压即用,始终追最新提交,仅限 Windows + NVIDIA(或纯 CPU)
- 手动安装:git clone + venv,支持所有 GPU 后端——NVIDIA、AMD、Intel、Apple Silicon,甚至昇腾 NPU 和寒武纪 MLU
模型不随安装分发,默认放在 ComfyUI/models/ 下按类型分目录:checkpoints/(单文件全量)、diffusion_models/(仅去噪骨干)、text_encoders/、vae/、loras/、controlnet/、upscale_models/。extra_model_paths.yaml 可以把外部目录挂进来,多套安装共用一份模型盘。工作流加载后缺模型会有红色警告,点开能看到缺哪个文件和下载链接;桌面版能直接自动下载(来源是 Hugging Face,网络不通就手动下)。
显存门槛大致分档:6–8GB 从 SD1.5 / SDXL / Z-Image Turbo 起步;12–16GB 可以跑 SD3.5、Flux.1 fp8、Qwen-Image fp8;24GB 以上 Flux.2 fp8 才从容。内存同样重要——32GB 以上建议文本编码器直接用 fp16 版。
二、默认工作流:六个节点跑通 txt2img
启动后默认加载的就是它,也是理解 ComfyUI 的最短路径:
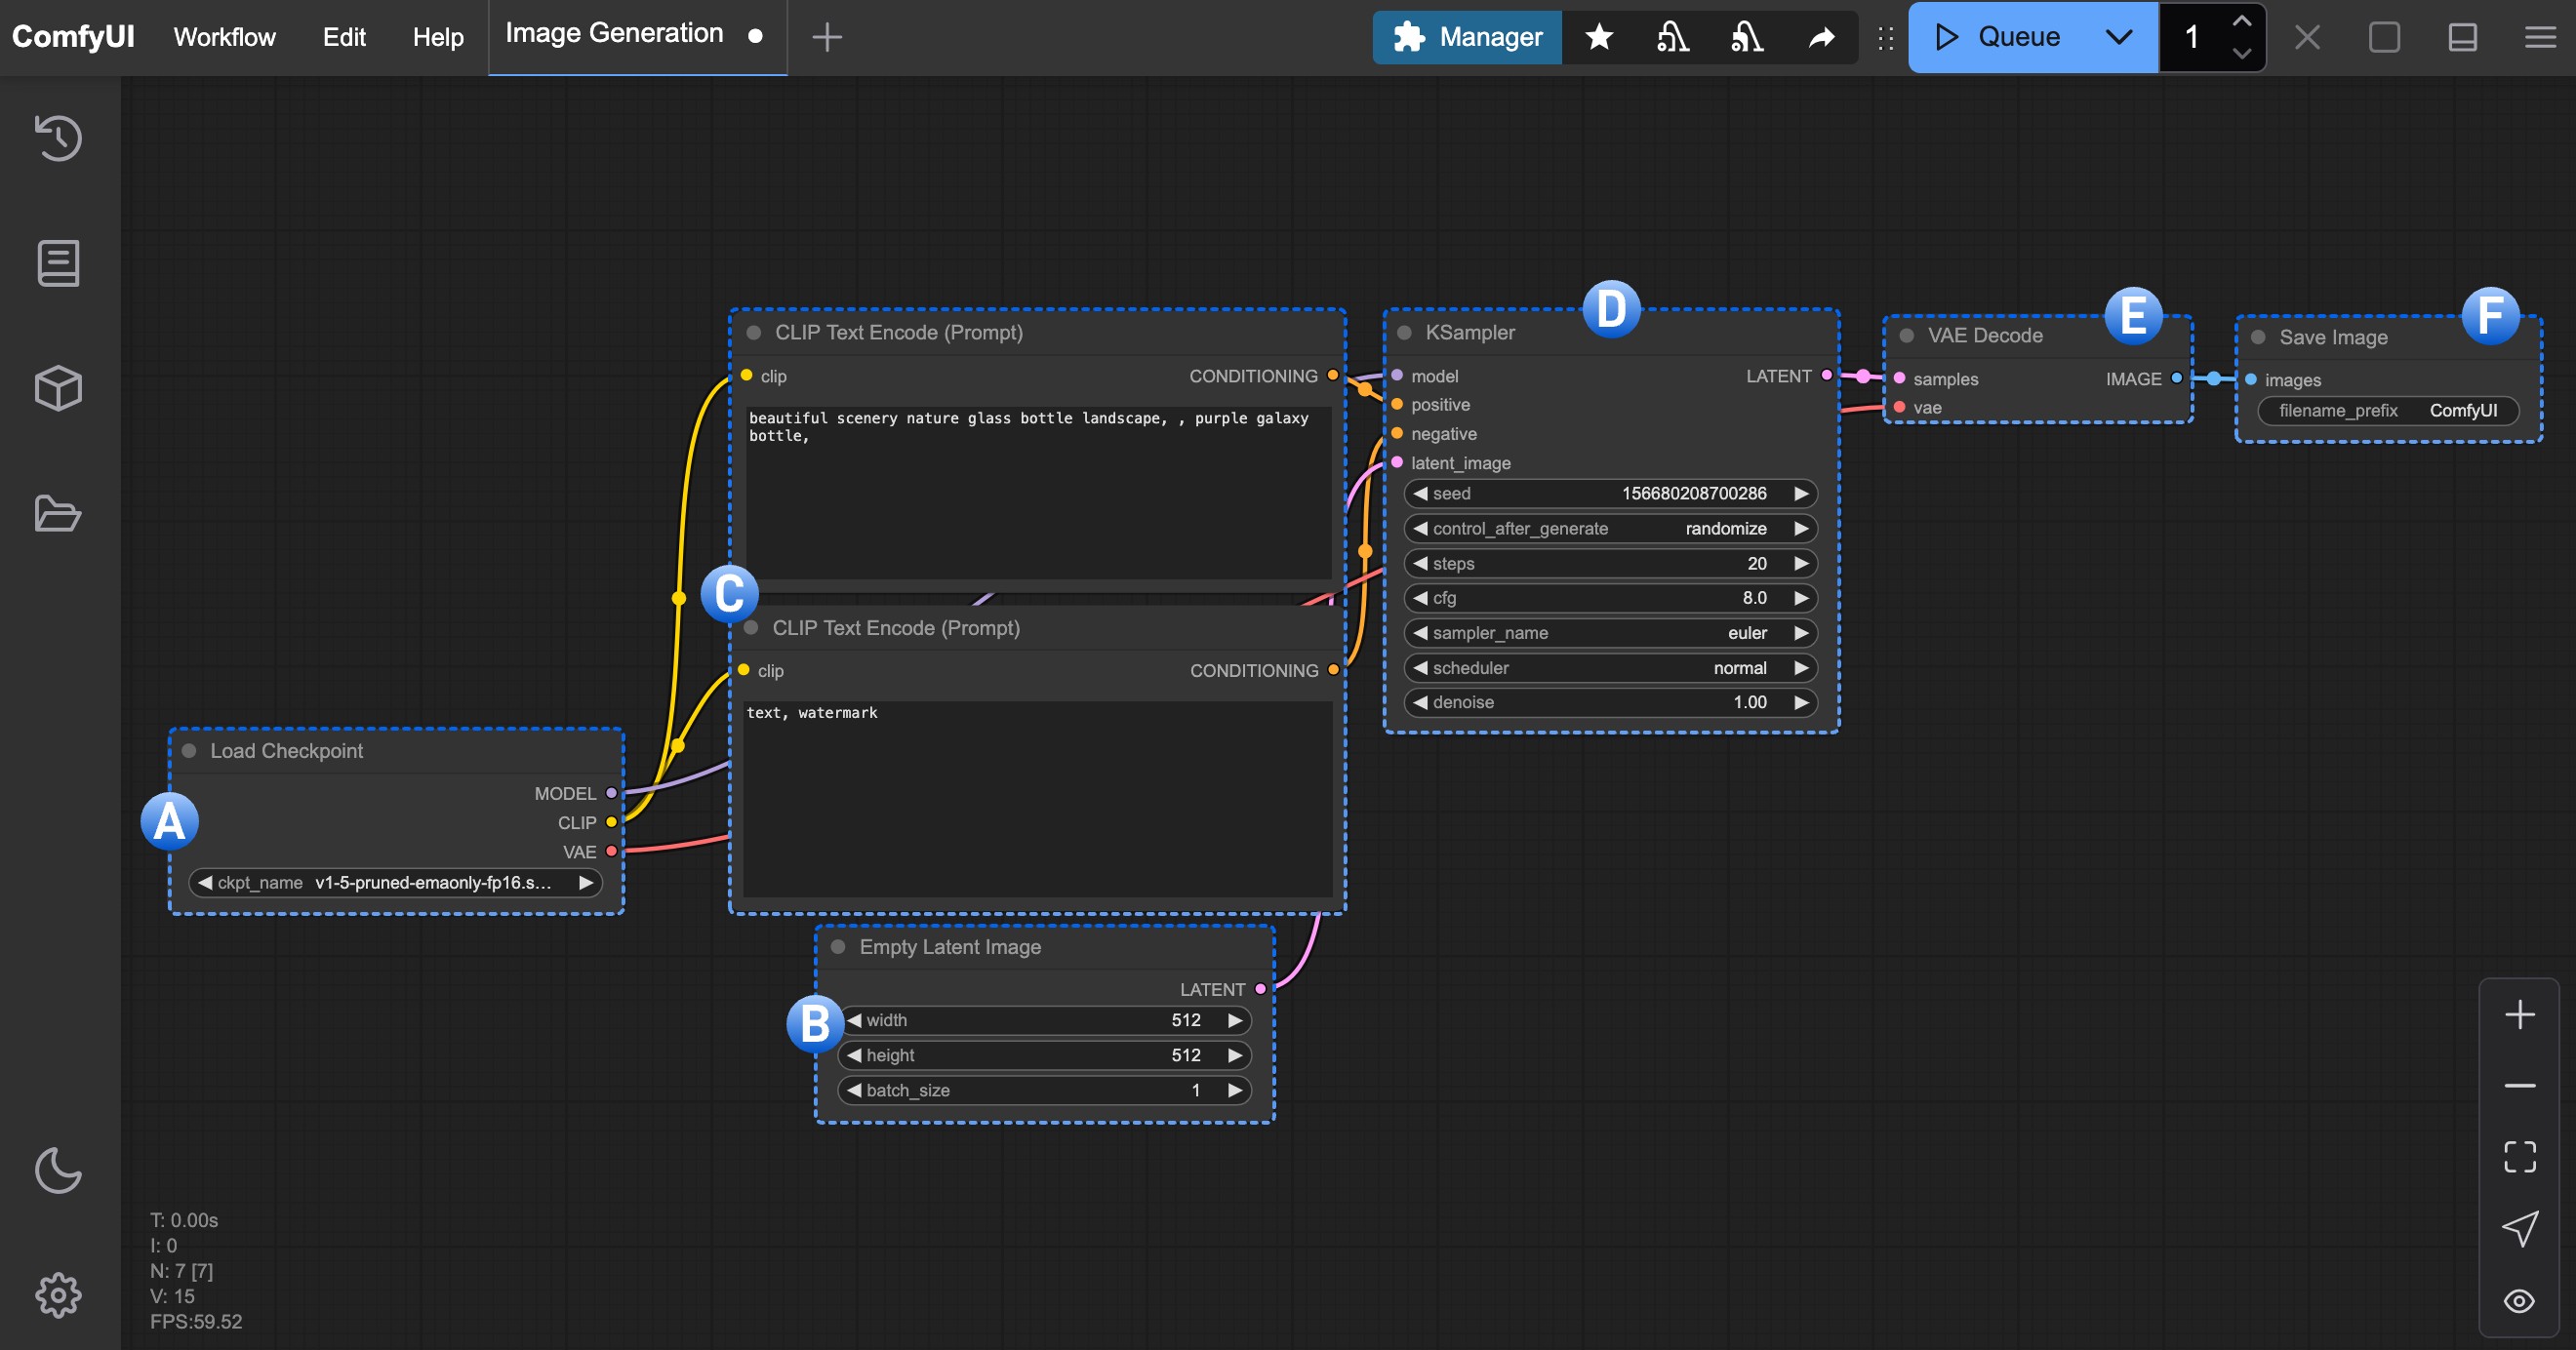
数据流从左往右:模型三件套、两路文本条件、一张「空画布」汇入 KSampler,出来的潜空间张量经 VAE 解码成像素图。
逐节点拆解:
Load Checkpoint。 加载单文件模型(safetensors),一个 checkpoint 内含三个组件并分三路输出:MODEL(UNet/DiT 去噪骨干)、CLIP(文本编码器)、VAE(潜空间与像素空间的编解码器)。三路分开输出正是后面「分体加载」工作流的伏笔。
CLIP Text Encode ×2。 正向提示词(想要的元素)与负向提示词(想排除的元素)各一个节点,文本经 CLIP 编码成语义向量作为条件送进采样器。SD1.5 时代的提示词写法:英文短语、逗号分隔、越具体越好,(golden hour:1.2) 这种括号语法可以给关键词加权,masterpiece, best quality 这类质量词对老模型有效。
Empty Latent Image。 定义画布尺寸——注意单位是潜空间尺寸,SD1.5 填 512×512,SDXL 填 1024×1024(或同像素量的其他宽高比,如 896×1152、1536×640)。
KSampler。 整个流程的核心,迭代去噪在这里发生:
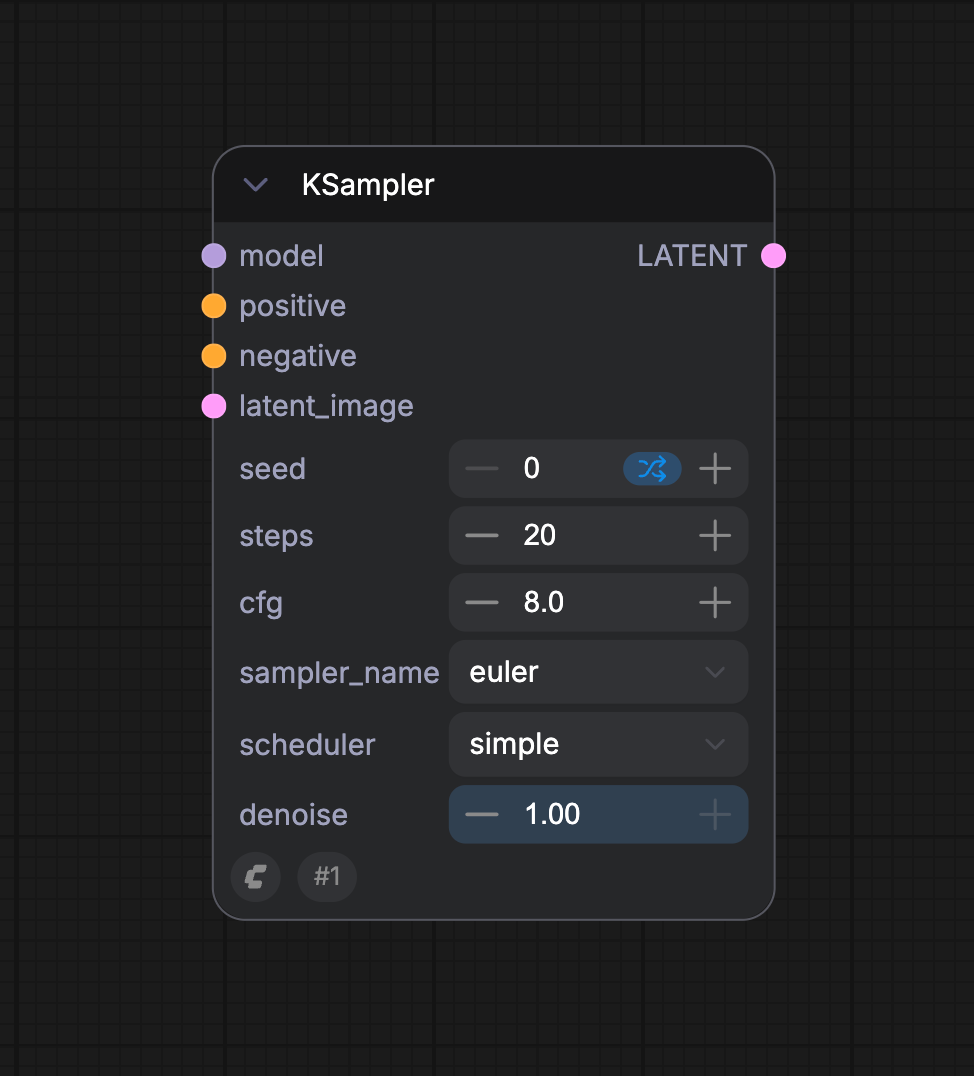
| 参数 | 作用 | 经验值 |
|---|---|---|
seed | 噪声初始化的随机种子 | 固定 seed = 复现同一张图;control_after_generate 控制批量时的变化规律 |
steps | 去噪迭代步数 | 步数越多细节越细但越慢;蒸馏模型 4–8 步即出图 |
cfg | 无分类器引导强度(提示词约束力) | 常规 4–8;过高会过饱和、烧坏画面;蒸馏模型常设 1.0–1.2 |
sampler_name | 去噪路径的数值算法 | euler 系快而稳,dpmpp_2m 系细节好,是多数工作流的默认 |
scheduler | 每步噪声幅度的衰减方案(normal/karras/exponential 等) | karras 与 dpmpp 系搭配常见 |
denoise | 加噪强度系数 | 1.0 = 从纯噪声完整生成;0.87 上下 = img2img 改图;0.3–0.5 = 精修 |
VAE Decode → Save Image。 潜空间张量解码回像素图,预览并落盘到 ComfyUI/output/。
💡 一个容易忽略的事实:ComfyUI 生成的每张 PNG 都把完整工作流 JSON 写进了元数据。把图拖回窗口(或 Workflows → Open)就能还原当时的整张节点图——分享配置的最高保真格式就是分享图本身。
改完提示词按 Ctrl + Enter 入队,按 R 刷新模型列表。对结果不满意就多跑几次——每次运行 seed 不同,出图也不同。
三、img2img、重绘与外绘:同一件事的三种参数
理解了 denoise,这三个「功能」就都消失了:
- img2img:把 Empty Latent Image 换成「Load Image → VAE Encode」,denoise 设 0.8 左右。denoise 越低加噪越少、改动越小——它就是唯一的「相似度」旋钮
- 局部重绘(inpaint):在 Load Image 的图上画 mask(右键 → Open in MaskEditor,或用带 alpha 通道的图),采样只发生在 mask 区域
- 外绘(outpaint):重绘的镜像,「Pad Image for Outpainting」节点自动向外扩边并生成对应 mask
在 ComfyUI 里没有「切到 img2img 模式」这个动作,只有「换了输入、调了 denoise 的同一张图」。
四、主流模型方案(2026)
| 模型 | 发布 | 规模要点 | 原生分辨率 | 许可证 | 定位 |
|---|---|---|---|---|---|
| SD 1.5 | 2022-10 | ~4GB(fp16 单文件) | 512 | 开放 | 生态最全的入门款,6GB 显存可跑 |
| SDXL | 2023-07 | ~7GB 单文件 | 1024 | OpenRAIL++ | 社区微调海量,出图快的实干主力 |
| SD3.5 | 2024-10 | Large 8B / Medium 2.5B | 1024 | 社区许可(年营收 < $1M 免费) | MMDiT 骨干,文字渲染与构图明显强于 SDXL |
| Flux.1 | 2024-08 | 12B | 1024–2048 | schnell Apache-2.0;dev 非商用 | 提示词遵循与文字渲染的上一代标杆 |
| Flux.2 | 2025-11 | 32B | 2K 级 | dev 非商用;klein Apache-2.0 | 当前开源质量天花板,多参考图编辑 |
| Qwen-Image | 2025-08 | 20B(+7B 文本编码器) | 1328 | Apache-2.0 | 中英文字渲染最强,编辑版支持 3 张输入图 |
| Z-Image Turbo | 2025-11 | 6B | — | Apache-2.0 | 8 步出图,消费级显卡的蒸馏快枪 |
几个值得展开的点:
SD1.5 为什么还活着。 官方教程至今用它演示默认工作流,不是保守——单文件 checkpoint、512 画布、六年积累的 LoRA 和 ControlNet 数量级领先,教学成本最低。新手上手可以直奔 SDXL,但 SD1.5 的生态资产短期内无可替代。
SDXL 的正确姿势。 checkpoint 用法与 SD1.5 完全相同,唯一要点是分辨率必须给到 1024×1024 的同像素量。官方 base + refiner 两段式如今用得少了,社区微调(Juggernaut 系等)一步到位;Stability 官方为 SDXL 出过 Control-LoRA(rank 256/128),用法与普通 ControlNet 文件完全一致。
SD3.5 与分体加载的常态化。 sd3.5_large.safetensors 不含文本编码器,需要单独加载 clip_l、clip_g、t5xxl 三个文件(t5xxl 有 fp16/fp8 两种,按内存选)。turbo 蒸馏版 4 步、cfg 1.2 即可出图;另有 sd3.5_large_fp8_scaled 单文件整合版可直接套默认工作流。官方还为 Large 出了 canny/depth/blur 三个 ControlNet。
Flux 家族。 dev 重质量、schnell 是 4 步蒸馏版(Apache-2.0,可商用)、Kontext 做指令式图像编辑。加载有两条路:fp8 单文件 checkpoint(普通 Load Checkpoint 节点,注意 CFG 必须设 1.0,蒸馏后不再需要引导);或分体加载——flux1-dev.safetensors 进 diffusion_models/,clip_l + t5xxl 进 text_encoders/(两路文本编码并联),VAE 单独进 vae/。显存吃紧时把 Load Diffusion Model 的 weight_dtype 设为 fp8,占用直接减半,画质损失很小。
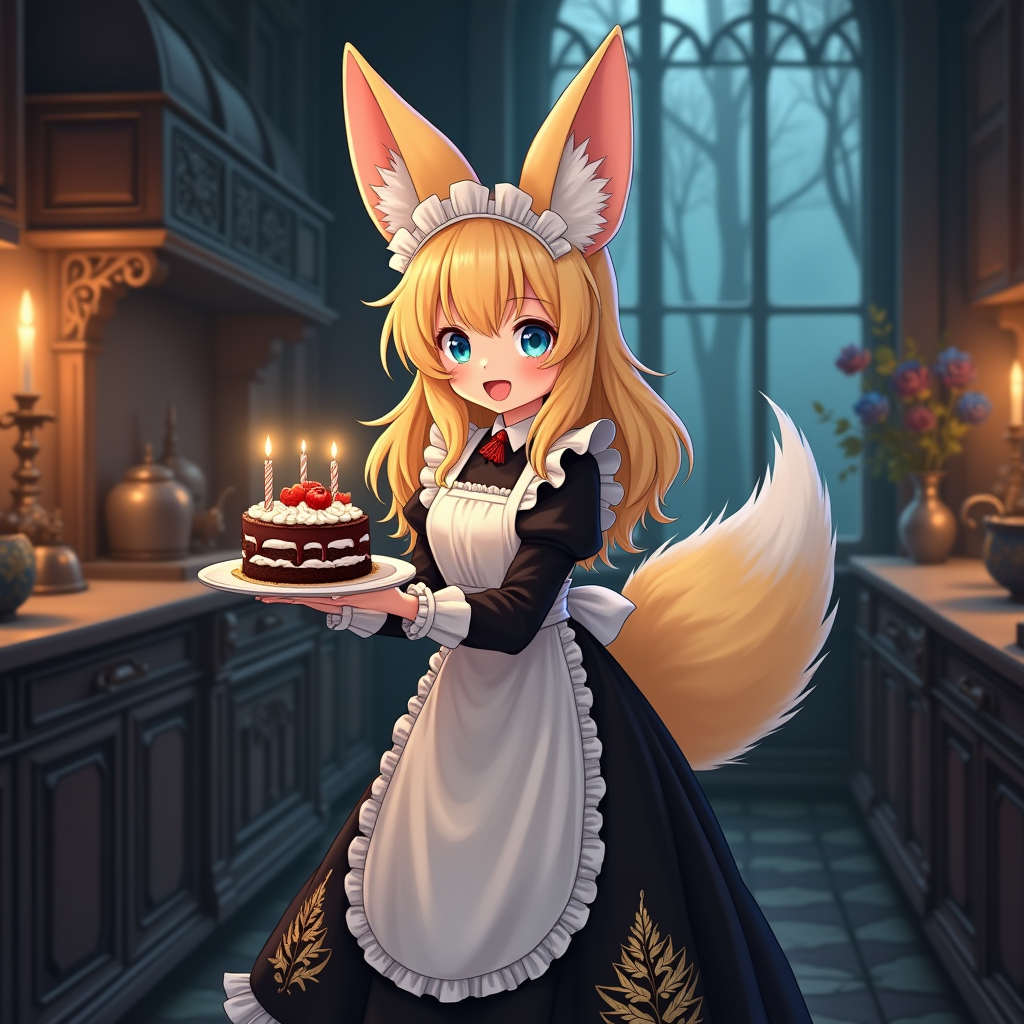
Flux dev 官方示例工作流的产出(1024×1024)。这张 PNG 原图内嵌完整工作流,拖回 ComfyUI 即可复现。
Flux.2。 2025 年 11 月发布的 32B rectified flow transformer,当前开源模型的质量上限。文本编码器换成基于 Mistral Small 3 的 mistral_3_small(fp8 版 18GB),支持多张参考图输入做编辑。门槛也实打实:fp8 骨干 + fp8 文本编码器在消费级显卡上单步要数秒。预算不够先看 klein——同代架构的小杯,Apache-2.0。
Qwen-Image。 20B 扩散骨干 + Qwen2.5-VL 7B 文本编码器的组合,Apache-2.0 全开放。招牌能力是中英文文字渲染——招牌、标语、UI 截图这类此前必翻车的场景现在可用:
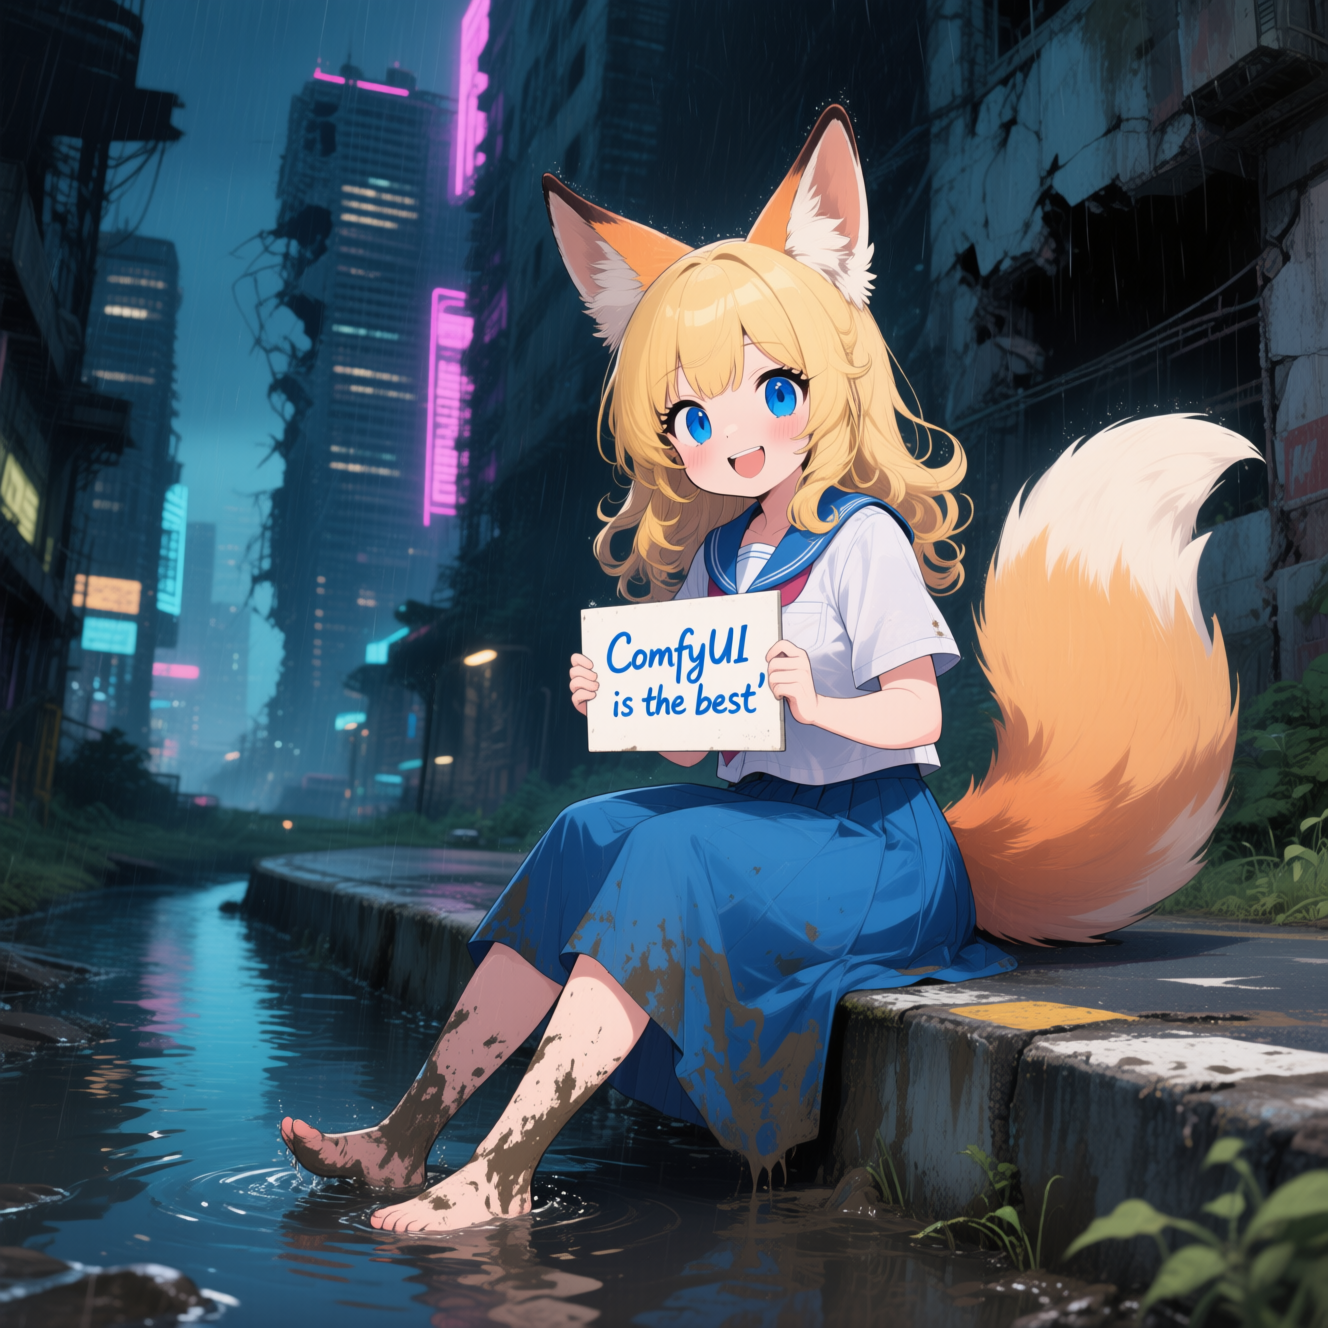
官方示例图里这行灯管字正是它的能力宣言——文字渲染一直是扩散模型的硬伤,能写对手写体英文的模型屈指可数。
Z-Image Turbo。 通义 2025 年 11 月的 6B 蒸馏模型,8 步出图、Apache-2.0,在低端显卡上把「能用的本地生图」门槛拉到了新低。类似的还有 HiDream、Chroma(Flux 系开放复刻)、Lumina 2、Hunyuan Image 2.1 等,生态一年轻过一年。
💡 分体加载成为常态的原因很实际:文本编码器跨模型复用(
clip_l/t5xxl下一套模型全家共享,别重复下载)、fp8 量化可以按组件选择、VAE 独立迭代。第一次配 Flux/SD3.5 工作流时「文件该进哪个目录」的答案都在各模型的官方说明里。
五、控制与精修四件套
ControlNet:用图控制构图。 文本说不清「左臂抬起 37 度」,一张姿态骨架图说得清。用法是「预处理 → Apply」两步:先用具身的预处理器把普通图片转成控制图(canny 边缘、深度图、姿态骨架、涂鸦线稿),再经 ControlNetApply 注入采样过程。注意 ControlNetApply 不会替你做预处理,喂原始照片进去效果会很差。
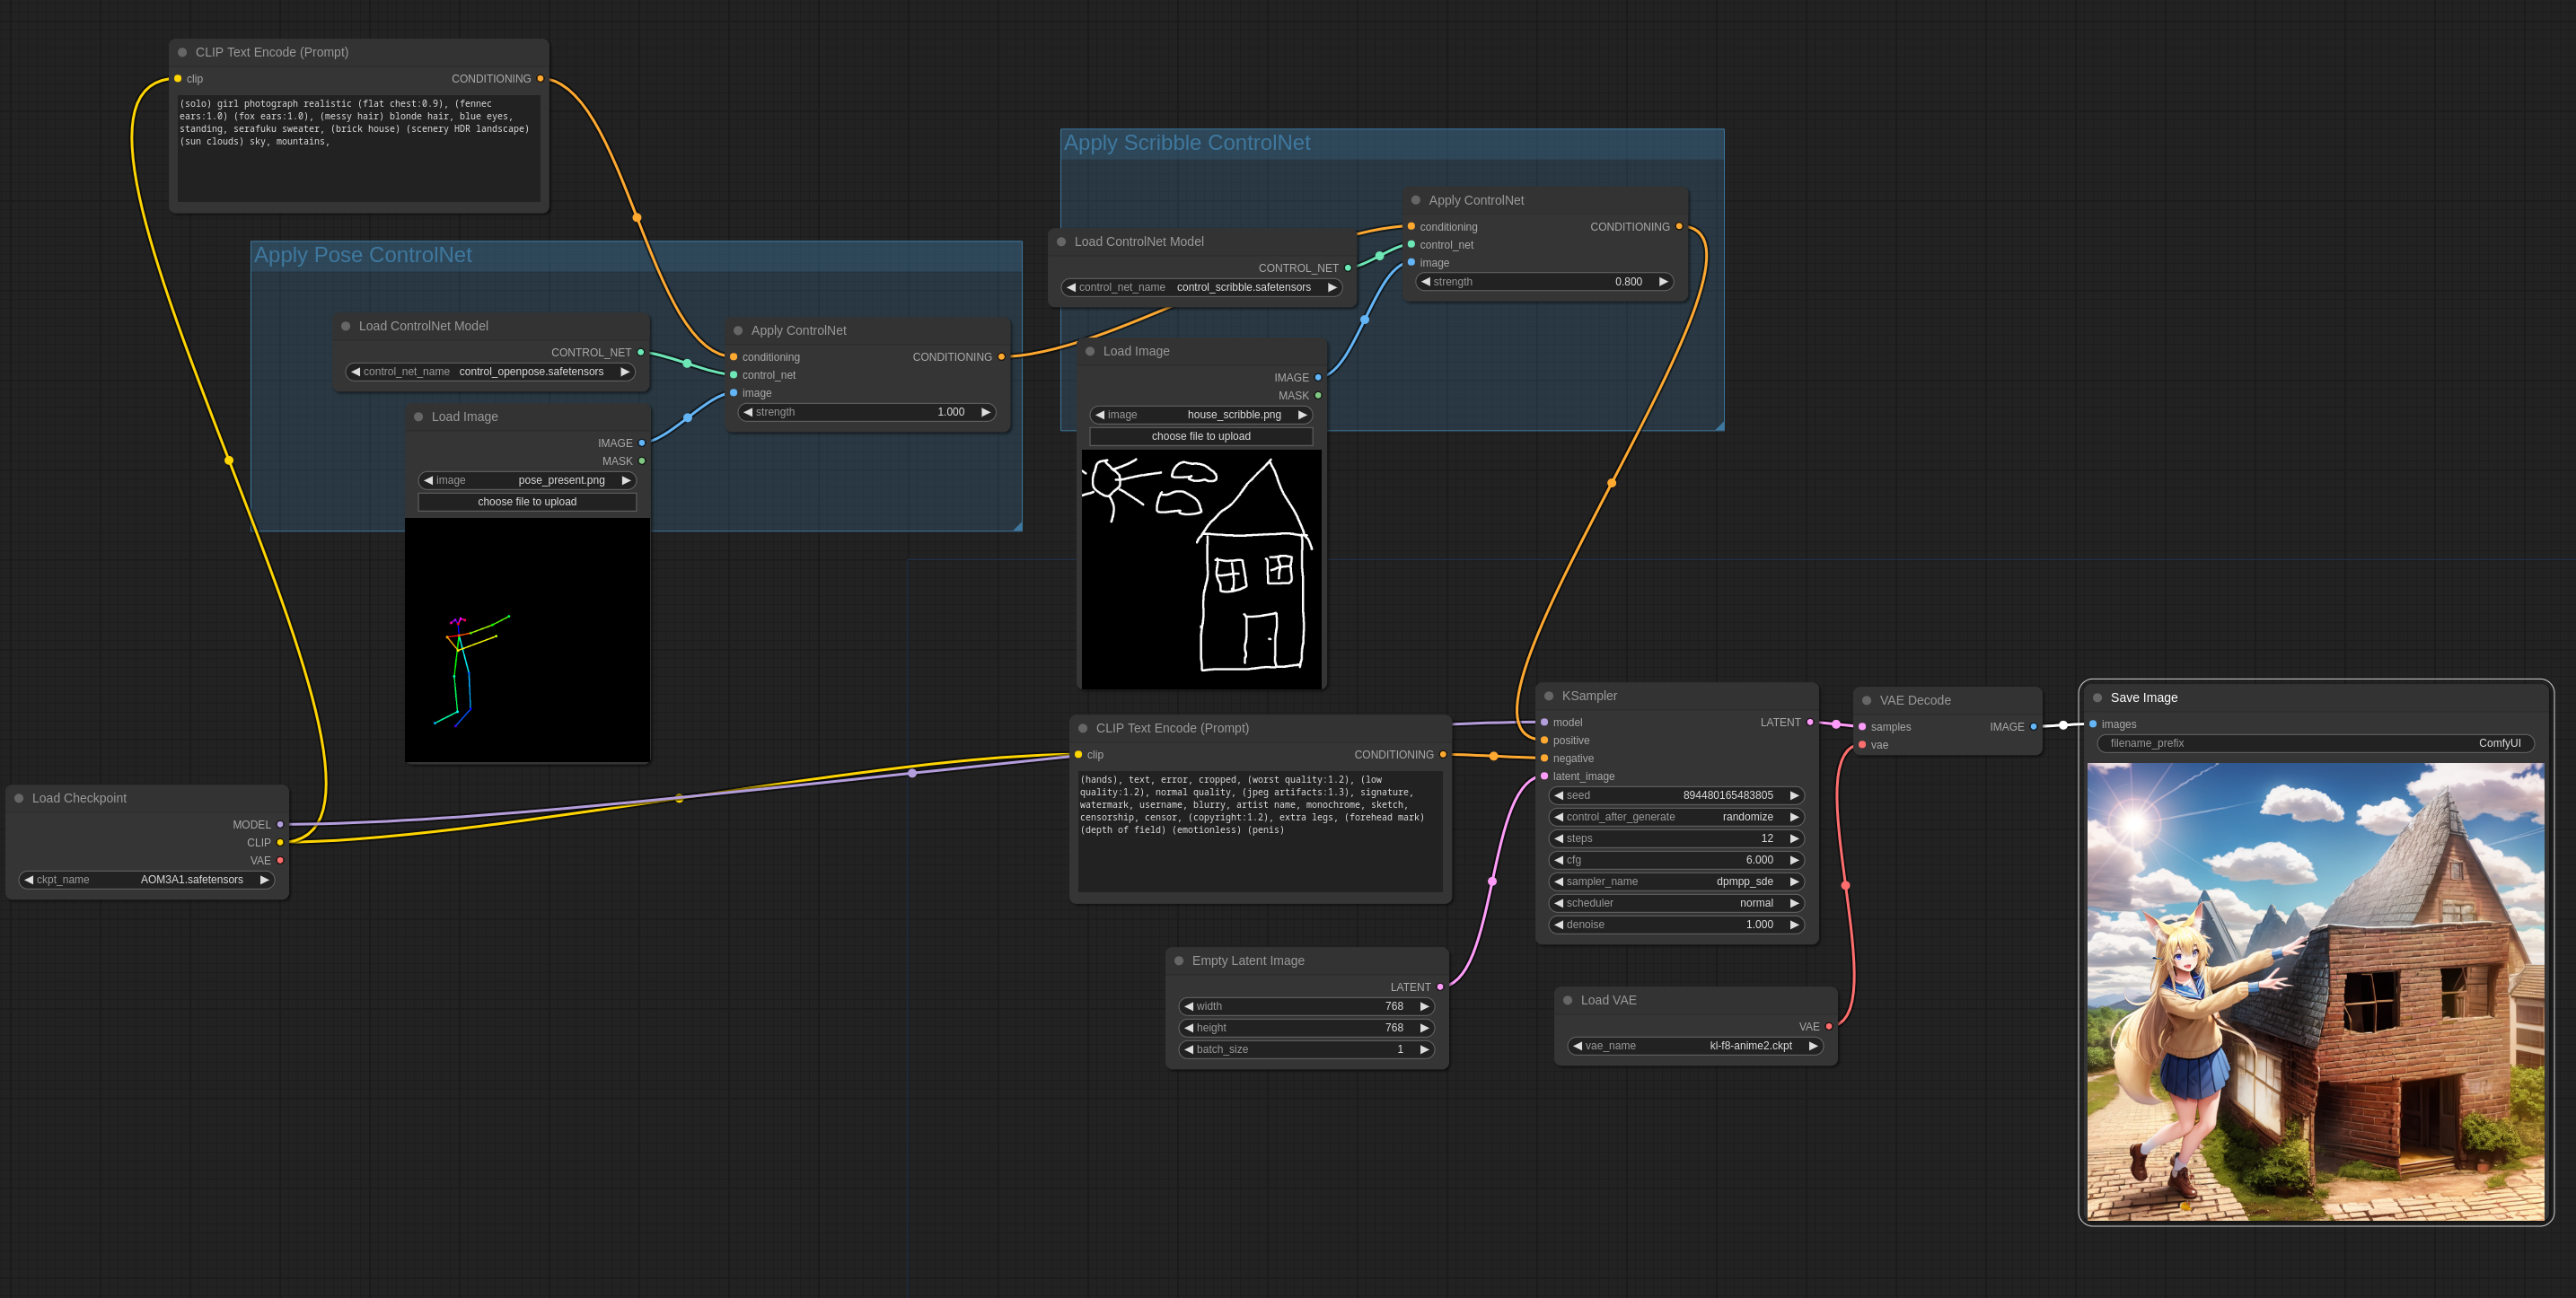
多个 ControlNet 可以串联混用,一个管姿态、一个管边缘,约束按权重叠加。
同场景还有个轻量替代——T2I-Adapter:ControlNet 在采样时每一步都要跑一遍旁路网络,T2I-Adapter 总共只跑一次,几乎不拖慢生成速度,精度略低。SD3.5 官方 ControlNet(canny/depth/blur)和 Flux 系的 canny/depth 变体也都按同一套节点用法接入。
LoRA:低秩补丁改风格。 LoRA 是打在 MODEL 和 CLIP 之上的低秩增量补丁,几百 MB 就能教会模型一种画风、一张脸或一类物件。用法极简:models/loras/ 放文件,LoraLoader 串进模型连线,调 strength(常规 0.8–1.0,压过就调低),模型页标注的触发词加进提示词。多个 LoRA 链式串联即可叠加:
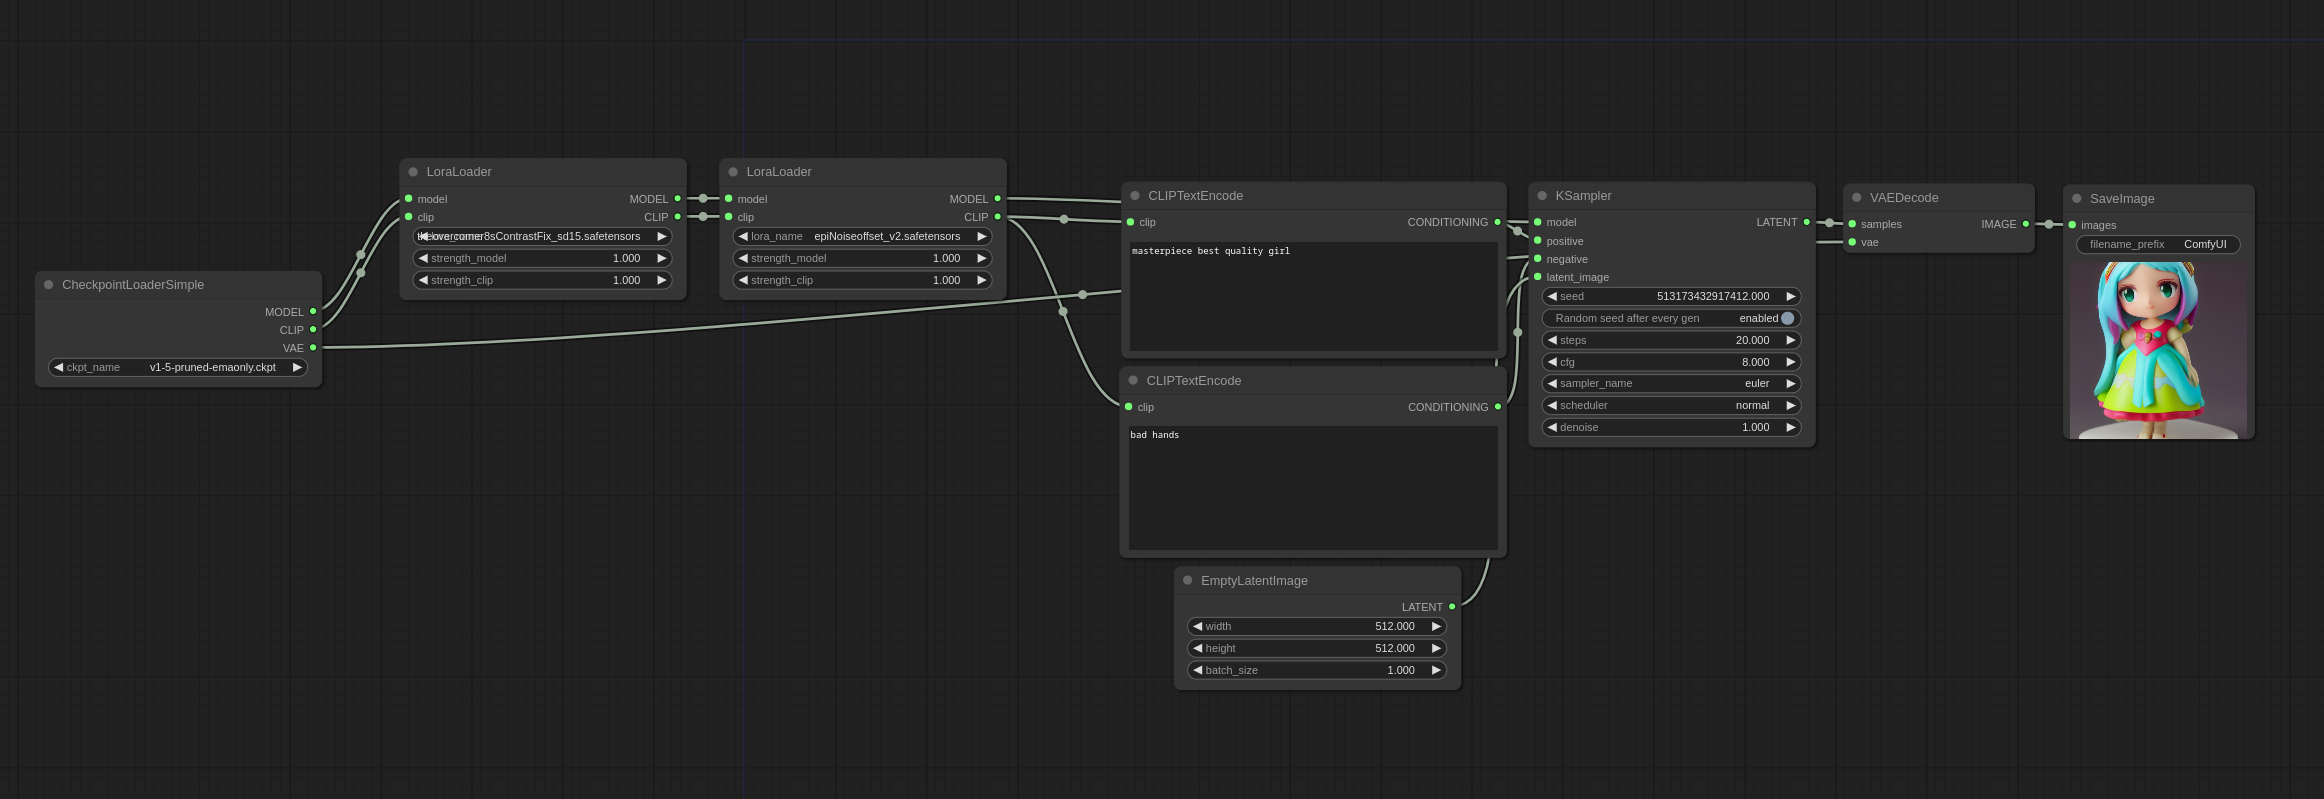
两个 LoraLoader 首尾相接,风格与角色补丁各挂各的,叠加顺序和权重都要试。
Hires Fix:两段式出高清图。 原理一句话:先低分辨率出图,放大,再用低 denoise(0.3–0.5)跑一遍 img2img 精修。放大这步有两条路——latent upscale(直接放大潜空间张量,新细节由模型画出来,快但可能加伪影)和模型放大(ESRGAN 类在像素空间跑完再编码回潜空间,稳但慢):
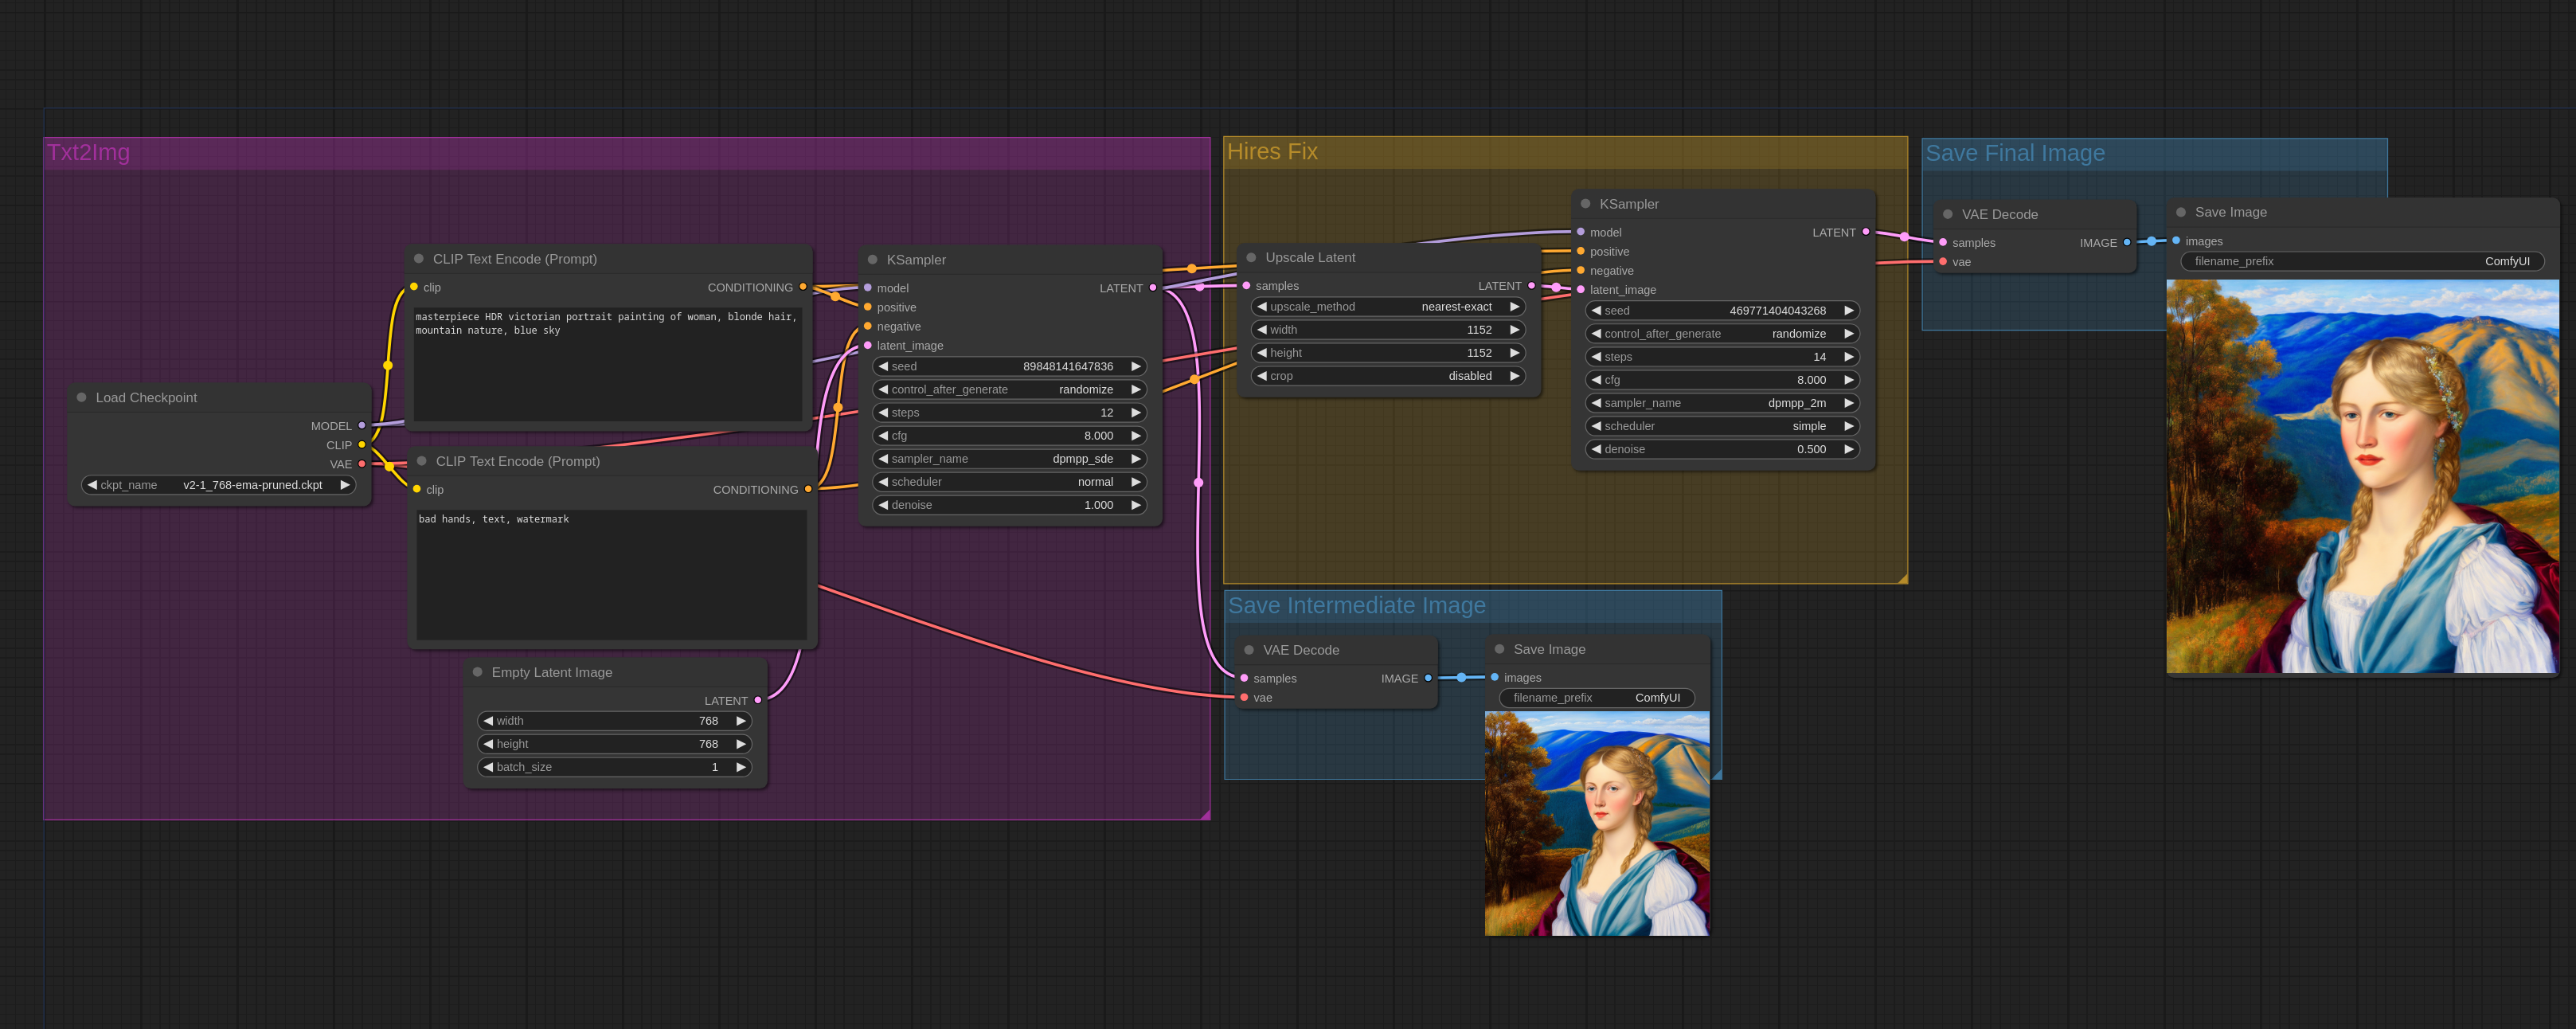
左半张是低分辨率粗稿,放大后右半张以 denoise 0.5 重采样——构图锁定,细节重画。
放大模型。 UpscaleModelLoader + ImageUpscaleWithModel 两个节点接在流程末尾,模型文件(4x-UltraSharp、各路 ESRGAN)放 upscale_models/,去 OpenModelDB 按题材挑。图太大爆显存就换 tiled 放大(分块处理再拼接)。
六、生态:Manager、模板与 API
- ComfyUI-Manager:事实标准的节点管理器,装/更/删自定义节点、下载模型、检测缺失节点并一键修复。别人分享的工作流打不开、满屏红节点时,先开它
- 模板库:Workflows → Browse Templates 里有官方按场景整理的模板;第三方站点 OpenArt、Civitai 沉淀了海量社区工作流,PNG 拖入即用
- API:ComfyUI 本体是 headless 引擎,
/prompt端点 + WebSocket 就能程序化提交工作流,前端不过是它的一个客户端。2026 年官方还在推 Comfy CLI 与 MCP 接入,让 agent 直接驱动生图
七、几点观察
- 「模式」的消失是设计哲学:denoise 是唯一开关,txt2img/img2img/精修共享同一组节点。从表单思维切换到数据流思维的那一刻,ComfyUI 的学习曲线就塌了——之后每个新功能都只是「多几个节点」
- 目录命名的新旧混用:老教程写
models/unet,新文档写models/diffusion_models——同一目录改名,新版两者都识别。官方示例站两个写法并存,按新名理解即可 - 官方文档的选型默认值在漂移:教程仍用 SD1.5 演示(教学成本最低),但示例站的权重清单已经以 Flux.2 / Qwen-Image / Z-Image 为主。8GB 显存的实用起点是 SDXL 社区微调 + Control-LoRA,不是 SD1.5
- 蒸馏模型重写了「步数换质量」的账本:schnell 4 步、Z-Image Turbo 8 步、sd3.5_large_turbo 4 步 cfg 1.2——蒸馏把引导需求也压掉了(CFG 逼近 1.0)。老教程里「steps 拉满 50」的经验对这批模型是错的,步数给多反而烧图
- 文本编码器成了独立资产:
clip_l/clip_g/t5xxl/qwen2.5-vl/mistral_3_small各配各的模型,磁盘里按text_encoders/归档一份全家用,下载前先查工作流要的是哪几个 - 本文配图已转 WebP,内嵌的工作流元数据随之丢失:要「拖图还原工作流」请用文末素材来源里的原始 PNG 链接
素材来源:ComfyUI 官方文档(docs.comfy.org 的 text-to-image / first_generation / image-to-image 教程)与官方示例仓库(comfyanonymous.github.io/ComfyUI_examples 的 flux / flux2 / qwen_image / sd3 / sdxl / controlnet / lora / 2_pass_txt2img / upscale_models / img2img / inpaint 各页),Flux.2 信息来自 Black Forest Labs 2025-11-25 发布公告,Z-Image Turbo 信息来自通义开源页。7 张配图全部取自上述官方渠道:6 张 PNG 转无损 WebP(SHA-256 比对解码像素零差异、未缩放),1 张 JPEG 源(官方标注工作流图)保留原格式——无损转换体积反增 64%,重编码无收益。
参考链接:
- 官方文生图教程 · 首次生成指南 · 图生图教程
- 官方示例站:Flux · Flux 2 · Qwen Image · SD3.5 · SDXL · ControlNet · LoRA · Hires Fix · 放大模型
- ComfyUI-Manager · FLUX.2 发布公告 · Z-Image-Turbo 模型页 · Qwen-Image 模型页