神经网络与反向传播
笔记 / AI 原理
深度学习的全部地基是两个函数:加权求和,过一道非线性。这篇讲这个最小单元长什么样、把它堆起来会发生什么,以及训练它的梯度从哪里来。拿到梯度之后怎么走是优化器的事,见 训练:损失、优化与稳定性。本分类全部笔记见 AI 原理。
一、一个神经元在做什么
1943 年 McCulloch 和 Pitts 提出第一个人工神经元的数学模型,抽象自生物神经元:上游信号加权累积,超过阈值就激活。数学形式只有一行:
- 是输入, 是每个输入的权重——可正可负,正的是兴奋性连接,负的是抑制性连接;
- 是偏置,决定这个神经元天生容易还是不容易激活;
- 求和结果叫净输入(也叫 logit), 是激活函数,负责过一道非线性。
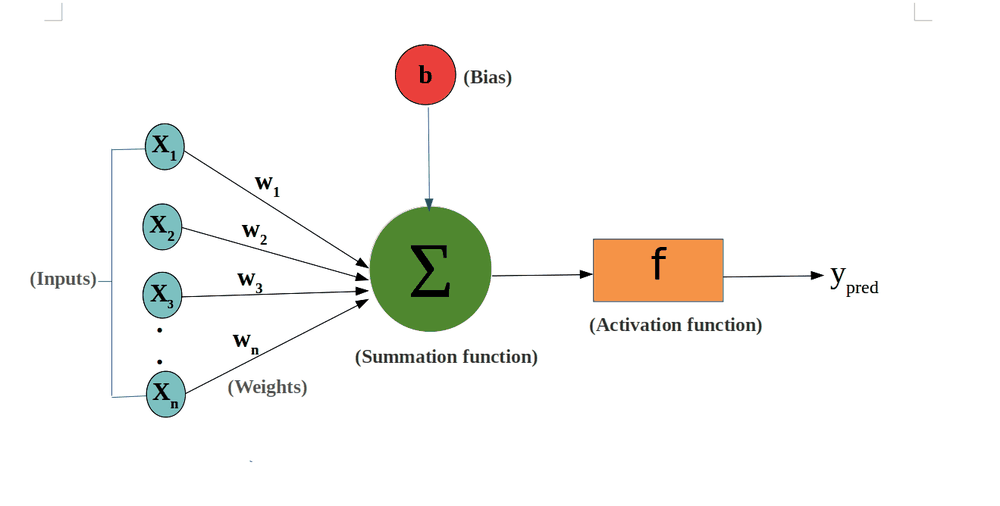
图:输入各自带上权重汇入求和节点,偏置单独接入,求和结果过激活函数得到输出。
一个具体例子:判断邮件是否垃圾邮件。设 =「是否包含『免费』」、 =「发件人是否在通讯录」、 =「是否深夜发送」。训练之后模型可能学到 (「免费」是强信号)、(通讯录是减分项)、、(默认倾向正常邮件)。净输入越大,越可能是垃圾邮件——这就是一个神经元能表达的全部判断。
二、激活函数:非线性不可省略
假设不设激活函数(),会发生什么?无论堆多少层,整个网络等价于一个单层线性模型——线性变换的复合仍是线性变换,一百层矩阵乘法可以合并成一次矩阵乘法。没有非线性,网络只能画直线(高维超平面),连异或(XOR)都分不开。
常见激活函数:
| 函数 | 表达式 | 现状 |
|---|---|---|
| Sigmoid | 两端饱和,深层网络梯度衰减严重,已不用在隐藏层 | |
| Tanh | 零中心,比 Sigmoid 好,仍会饱和 | |
| ReLU | 正区间梯度恒为 1,计算最便宜,深度网络的默认起点 | |
| GELU | 平滑版 ReLU,Transformer 系列用 | |
| SwiGLU | 门控变体,LLaMA / PaLM 采用,见 自注意力与 Transformer |
ReLU 统治地位的关键就一条:正区间导数恒为 1。Sigmoid 的导数最大只有 0.25,过几十层连乘后梯度衰减到浮点噪声级别(详见 训练:损失、优化与稳定性);ReLU 把这条衰减链直接剪断了。另外它还有个工程红利——max(0, z) 不需要算指数。
三、堆叠:特征层次与万能逼近
单个神经元只能画一条直线。XOR 问题——四个点 、、、——无法用一条直线分开,Minsky 和 Papert 在 1969 年严格证明了这一点,直接引发了第一次 AI 寒冬。
加一个隐藏层就解开了。万能逼近定理说:隐藏层神经元足够多的两层网络能以任意精度逼近任何连续函数。但注意它承诺的是”存在这样一组权重”,不承诺梯度下降找得到、也不承诺需要多少神经元——工程上的全部难点在这个缝隙里。
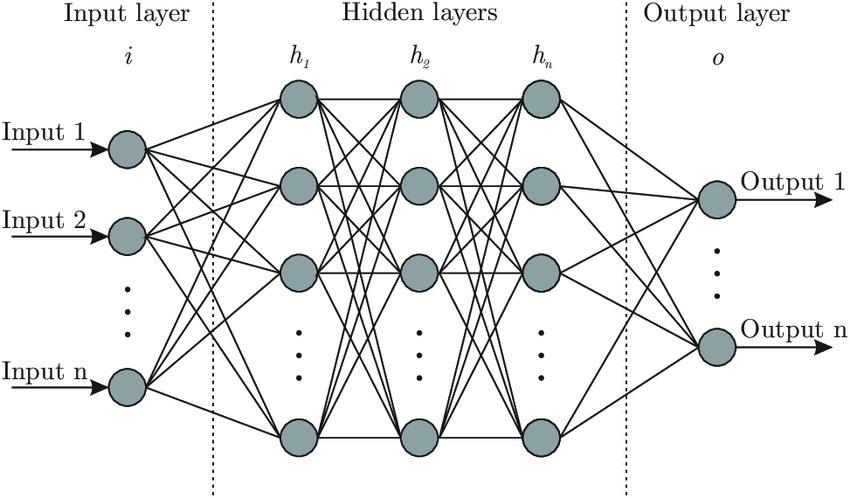
图:输入层 → 隐藏层 × N → 输出层,层间全连接。
堆叠出来的另一个性质是特征的层次结构:浅层学到边缘、颜色分界这类基本元素,中层把它们组合成部件(眼睛、轮子),深层对应完整语义(一张猫脸)。这个分工不是人设计的,是训练中自动涌现的——它也大致对应人类视觉皮层从 V1 到 IT 区的层级处理,是神经科学与深度学习少数直接对应的地方。卷积网络把这个层次结构做成了专门处理图像的架构,见 从 CNN 到 Vision Transformer。
四、反向传播:梯度从哪里来
有了网络,训练只需要一个问题:每个参数对最终误差贡献了多少? 反向传播(Rumelhart、Hinton、Williams,1986)用链式法则回答它,流程四步:
- 前向传播:输入逐层算到输出,同时缓存每层的中间结果——反向时要用;
- 算损失:预测与标签比较,得到一个标量;
- 反向求导:从输出层开始,用链式法则逐层反算损失对每个参数的偏导;
- 更新参数:交给优化器(如 AdamW)按梯度更新。
第 1 步那句”缓存中间结果”是工程本质:局部导数依赖前向算出的值,所以训练要用显存换计算。
手算一遍
设 、、、激活 、标签 、学习率 。
前向:,。损失:。
反向(链式法则自外向内):
更新:,。两个参数都增大——梯度为负,减负等于加正,输出从 49 朝 50 靠近了一步。
为什么这个算法重要
上面只有两个参数,链式法则显得小题大做。它的真正价值在于:无论多少层、多少参数,一次反向传播的代价只有一次前向传播的两倍左右,每个参数都拿到自己的梯度。千亿参数的模型能被训练,靠的就是这条性质。
最后理清一个常见混淆:反向传播和梯度下降不是一回事。反向传播回答”每个参数的梯度是多少”,优化器回答”拿到梯度后怎么走”——前者是求导机器,后者含学习率、动量、自适应缩放这些策略,两者的分工见 训练:损失、优化与稳定性。