自注意力与 Transformer
笔记 / AI 原理
2017 年之前的序列模型(RNN/LSTM)按词序逐个处理,上一个词的结论通过一个隐藏状态传给下一个词——顺序计算无法并行,长距离信息一路衰减。Transformer(Attention Is All You Need,2017)用一句话终结了这个局面:让每个词直接看到所有词。这篇讲注意力本身、它外面的块结构,以及 2024 年后前沿模型在块结构上做的两处关键改造。本分类全部笔记见 AI 原理。
一、注意力在算什么
一句话概括:每个词向所有词发问,按匹配程度收回信息。
处理「小明把书给了小红,因为她要考试」里的「她」时,模型需要判断「她」指小明还是小红——判断依据(性别、语境)分散在其他词里。注意力机制让「她」拿自己的表示去和全句每个词比对相似度,按分数加权把大家的信息汇总回来。
实现上每个词的嵌入被三个矩阵投影成三个角色:
- Query(查询):我在找什么信息;
- Key(键):我能提供什么信息,用来被检索;
- Value(值):我实际携带的内容。
一次注意力的完整计算:
拆开看三步: 算出每对词的匹配分数(点积衡量向量相似度);softmax 把每一行的分数变成归一化的权重;再对 加权求和,每个词得到一份按相关性混合的全句信息。
除以 不是细节装饰:维度越高点积的方差越大,大方差过 softmax 后分布会退化成一个 one-hot——只剩最大分得到全部权重,梯度消失。缩放把方差拉回 1,保住softmax 的梯度。这类「梯度在最需要的地方消失」的病在 训练:损失、优化与稳定性 里反复出现,这里是同一个主题在注意力里的版本。
二、多头:并行问几种问题
一组 QKV 只能问一种问题。多头注意力把 维空间切成 份(如 64 维 × 12 头),每头独立做注意力再拼接,参数量不变,表达能力翻倍:经验上有的头追踪句法依赖(主谓一致)、有的追踪位置相邻、有的专门看分隔符。这不是设计出来的分工,是训练后检查出来的——注意力的可解释性研究基本靠读这些头的模式。
三、一个块的解剖
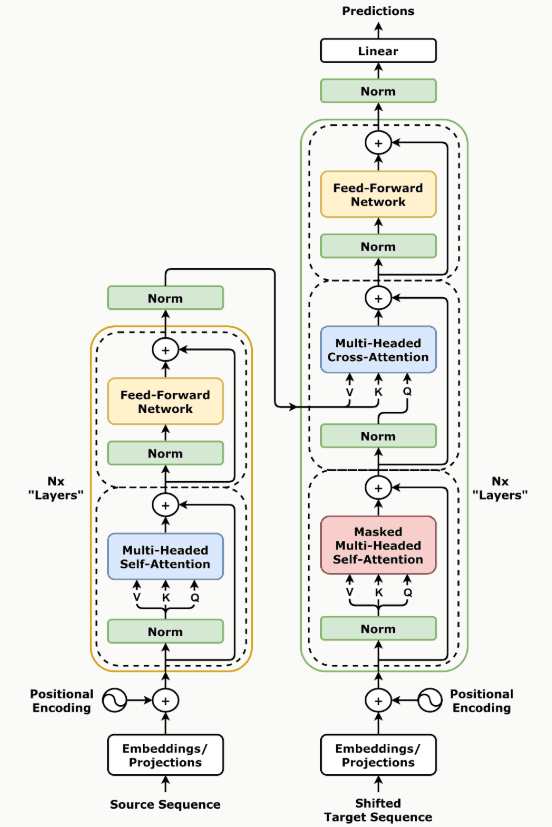
图:一个 Transformer 块 = 注意力子层 + 前馈子层,各配残差与归一化。整个模型是 N 个这样的块堆叠。
两个子层的分工有个好用的比喻:注意力负责词与词之间交流,前馈网络(FFN)负责每个词自己消化。FFN 是两层的全连接(中间维度通常是 的 4 倍),参数占整个模型的三分之二,解释性研究发现许多事实知识(「巴黎是法国首都」)就存在这里的权重里——所以后来的 MoE 改造动的是 FFN,不是注意力。
块结构本身的三个现代演化:
- Pre-Norm 替代 Post-Norm:原论文把归一化放在子层之后,深了难训;现在的做法是先进归一化再进子层,残差主路上没有任何变换,梯度直通——和 训练:损失、优化与稳定性 里残差连接的 +1 是同一个逻辑。
- RMSNorm 替代 LayerNorm:去掉减均值那步,只按均方根缩放,少一次统计、效果不降,LLaMA 之后的开源模型基本都换掉了 LayerNorm。
- SwiGLU 替代 ReLU/GELU:门控激活。为了参数量对齐,中间维度从 调成 ——换激活函数要连维度一起换,这是常被漏掉的配套改动。
位置信息在原论文里是正弦位置编码加在输入上;现代主流是 RoPE(旋转位置编码),把相对位置编进 Q/K 的旋转角里,细节在 从 token 到文本。
四、复杂度:二次代价与工程对策
注意力对序列长度是 :序列翻倍,计算与显存翻四倍。这是长上下文一切困难的根源。两条对策方向:
- 不改数学的:FlashAttention 系列把注意力的分块计算重排,让中间结果尽量留在 SRAM 里不写回 HBM——数学完全等价,纯 IO 层面的优化,已是训练与推理的默认件。
- 改数学的:稀疏/线性注意力、滑窗(Mistral 的 32k 滑窗)、状态空间模型(Mamba)等,牺牲一部分全局性换复杂度,仍在演进。
推理侧的 还有个专门的账本问题——KV Cache,见 从 token 到文本。
五、现代改造:GQA 与 MoE
GQA:给 KV 头打包
推理时生成每个新 token 都要重读全部历史的 K/V,缓存它(KV Cache)是显存大头。多头注意力的 KV 头数等于 Q 头数(如 32 头就有 32 份 KV),**分组查询注意力(GQA)**让若干个 Q 头共享一份 KV(如 32 个 Q 头共享 8 份),KV Cache 直接缩到四分之一,生成质量几乎不掉。LLaMA-2 70B、LLaMA-3、Qwen、DeepSeek 全用它,再激进些的 MQA(全部 Q 头共享 1 份 KV)质量损失开始可见——GQA 是当前的平衡点。
MoE:容量与算力解耦
把每块的 FFN 换成 N 个并行的「专家」网络,加一个路由器:每个 token 只被路由到其中少数几个专家。效果是参数量与计算量解耦——模型的知识容量按总参数算,推理成本只按被激活的部分算。
DeepSeek-V3 是这套思路的成熟样本:671B 总参数,每个 token 只激活 37B。它的两点工程化设计后来被广泛采纳:一是细粒度专家 + 共享专家——把专家切小、每 token 路由到 8 个,另设 1 个所有 token 必经的共享专家承接通用知识;二是无辅助损失的负载均衡——早期 MoE 靠辅助损失惩罚「路由偏科」,调不好就顾此失彼,DeepSeek-V3 改成给每条路由加一个可直接调节的偏置项,均衡不再与主损失打架。
MoE 的代价在训练与部署:所有专家都要驻留显存、路由让张量并行更复杂、负载不均会浪费算力。但「同样推理算力下更大容量」这笔账太划算,2024 年后的前沿开源模型几乎清一色是 MoE。
到此,语言模型的架构零件齐了:怎么把文本切成 token、怎么表示位置、怎么一步步生成,是 从 token 到文本;怎么在工业规模上把它训出来并对齐成助手,是 大语言模型的训练与对齐。视觉领域则证明这套架构不挑输入——图像切块当 token 照样能训,见 从 CNN 到 Vision Transformer。