训练:损失、优化与稳定性
笔记 / AI 原理
反向传播算出每个参数的梯度之后,剩下的全部问题是:沿梯度怎么走、走多快、走崩了怎么办。这篇把训练里损失、优化器、稳定性、正则化四件事一次讲完。本分类全部笔记见 AI 原理。
一、损失函数:模型在乎什么
损失函数把「预测得好不好」压缩成一个标量,它是模型唯一的在乎——优化什么就得到什么,选错损失函数,训练再充分也是南辕北辙。
| 损失 | 公式 | 适用 |
|---|---|---|
| 交叉熵 | 分类(配 softmax) | |
| 均方误差 MSE | 回归(对离群值敏感) | |
| 平均绝对误差 MAE | 回归(抗离群值) |
MSE 对离群值敏感不是缺陷而是后果:平方放大了大误差的惩罚,模型会优先牺牲小误差的去拟合大的。一个典型表现是用 MSE 训练图像去噪时输出偏模糊——多张合理答案的均值在像素意义上最省损失,而人眼要的是清晰的那一张。后来扩散模型用「预测噪声」而不是「预测图像」作为目标,部分就是在绕开这个问题(见 扩散模型)。
分类任务配交叉熵同样有讲究:交叉熵衡量两个分布的距离,而 softmax 把网络输出变成概率分布——这一对组合的梯度恰好是 ,形式干净且不会像 MSE 配 softmax 那样在错误很离谱时梯度反而趋零。
二、梯度下降与学习率
学习率 是深度学习里最敏感的超参数:太小时损失下降慢到看不到头,太大时在最优点附近来回越过谷底、损失震荡甚至发散(损失变 NaN 的第一嫌疑犯)。现代做法是warmup 加余弦衰减:开头几百步线性爬升避免随机初始化阶段的大梯度把参数带飞,随后平滑降到接近零。
工程上没有人用全量数据算一步梯度——那是把整个数据集过一遍才更新一次。实际全部用 mini-batch:每次取几十到几千个样本,用 batch 内平均梯度近似全量梯度。batch 太小则梯度噪声大、GPU 利用率低;太大则显存放不下且泛化反而变差。这个噪声不全是坏事——它给优化轨迹加了扰动,帮助跳出尖锐的极小值,往平坦的盆地走,而平坦解通常泛化更好。
三、优化器:从 SGD 到 AdamW
朴素 SGD 对每个参数用同一个学习率,但损失面在不同参数方向上的陡峭程度差几个数量级。优化器六十年的演进全在解决「每个参数该有自己的步幅」:
| 优化器 | 核心思想 | 遗留问题 |
|---|---|---|
| SGD | 梯度直接走 | 各方向共用一个学习率 |
| Momentum | 累积历史梯度做惯性,穿过窄谷震荡 | 仍是单一学习率 |
| AdaGrad | 按梯度平方累积缩放,稀疏特征步幅自适应 | 累积量只增不减,后期步幅归零 |
| RMSprop | 平方项改指数滑动平均,AdaGrad 的修复 | — |
| Adam | Momentum + RMSprop,再加偏差修正 | 默认选择,但权重衰减有坑 |
| AdamW | 权重衰减与梯度解耦 | 当前默认 |
AdamW 那个坑值得单独说:Adam 原始实现把权重衰减加进损失里,衰减项因此被自适应学习率缩放——每个参数受到的衰减强度取决于自己的梯度历史,梯度大的参数反而衰减得多,与 L2 正则的本意不符。AdamW 把衰减从梯度里拆出来,作为独立项直接从权重里减。一字之差,在许多任务上是几个百分点的差距。今天从头训练几乎无脑选 AdamW;只有视觉领域的一些经典工作仍坚持 SGD + Momentum,那是超参调优到位后的特例,不是通则。
四、深度的障碍:梯度病与两个解法
反向传播逐层相乘局部导数。若每层导数普遍小于 1(比如 Sigmoid 最大 0.25),几十层连乘后到达浅层的梯度衰减成浮点噪声——梯度消失,浅层参数等于没训;反过来普遍大于 1 则指数爆炸,训练直接 NaN。深网络能训起来,靠的是两件套:
残差连接(ResNet,2015)。把层的学习目标从「输出目标」改成「输出目标减输入」,即每块只学增量:
那个 +1 是全部魔法:梯度回传时多了一条恒等直通道,无论 多小,梯度至少原样到达浅层。原论文有个反直觉的实验佐证:56 层普通网络的训练误差高于 20 层——不是过拟合,是深了反而训不动;换成残差结构后 152 层照常收敛。残差连接从此成为一切深架构的默认件,Transformer 每个块里也有。
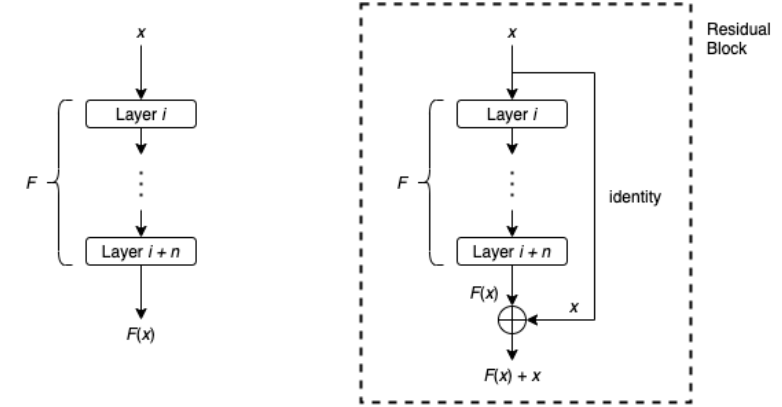
图:输入一路直通、一路过变换,相加输出。梯度可以沿直通路无损回传。
归一化层。把每层输出的数值范围强行拉回稳定区间,让下一层的输入分布不随训练漂移:
| 方法 | 归一化维度 | 现状 |
|---|---|---|
| BatchNorm | 同一特征在 batch 内归一化 | CNN 时代标配;依赖大 batch,训练/推理行为不一致 |
| LayerNorm | 同一样本的所有特征归一化 | Transformer 的选择,与 batch 大小解耦 |
| RMSNorm | LayerNorm 去掉减均值,只做缩放 | 更简单且效果不降,LLaMA 系与主流 LLM 采用 |
梯度爆炸比消失好治得多——梯度裁剪(gradient clipping)把超过阈值的梯度整体缩回来,一行代码,见 大语言模型的训练与对齐。
五、正则化:治过拟合
训练损失还在降、验证损失开始升,就是过拟合——模型背下了训练集的噪声。常用手段按干预位置分:
| 手段 | 机制 |
|---|---|
| Dropout | 训练时随机置零一部分神经元,逼网络不依赖单一路径 |
| 权重衰减 | 惩罚大权重,偏好更平滑的解(AdamW 里的 W) |
| 早停 | 验证集损失最低点即停,最便宜的正则化 |
| 数据增强 | 变换数据造新样本,图像领域收益最大 |
Dropout 有个容易被忽略的细节:推理时要关闭随机置零并缩放补偿(或训练时做 inverted dropout),否则输出期望变了。Transformer 里 Dropout 至今仍在用,但注意力头层面的冗余本身就在提供类似的鲁棒性。
至此,单机训练一个网络的全套零件凑齐了。真正的语言模型还差三件事:处理序列的架构(自注意力与 Transformer)、从文本到 token 的表示(从 token 到文本)、以及工业规模的训练流程(大语言模型的训练与对齐)。