从 CNN 到 Vision Transformer
笔记 / AI 原理
图像进入神经网络的第一个问题是表示:一张图怎么变成数字。这篇从张量与卷积讲起,到 2020 年范式迁移——图像也用 自注意力与 Transformer 处理。特征层次化的直觉在 神经网络与反向传播 已铺过,这里直接用。本分类全部笔记见 AI 原理。
一、图像是张量
图:一张 RGB 图像 = 高 × 宽 × 3 的三维张量,每个元素是 0–255 的像素值。
灰度图是 的矩阵,彩色图多出 RGB 三个通道——所谓「看懂图像」,从头到尾都是在这个数字立方体上做运算。
二、卷积:滑动的滤波器
全连接网络直接吃图像有两个致命伤:参数量随像素数平方级爆炸(一张 224×224×3 的图超过 15 万输入,第一层就要上亿参数);而且把图打平成向量,丢掉了空间结构——相邻像素的关系和首尾像素的关系被同等对待。
卷积用一个很小的核(kernel,常用 3×3)在图上滑动,每个位置做一次对应元素相乘求和,输出一张特征图:
图:3×3 核扫过整张图,每个窗口位置产出一个输出值。
一个卷积层同时跑几十到几百个核,各自学一种模式,输出叠成多层特征图。三个超参数控制几何:kernel 大小(感受野,3×3 是现代主流)、stride 步长(每次滑几格,>1 就是降采样)、padding 补边(四周补零保住输出尺寸)。
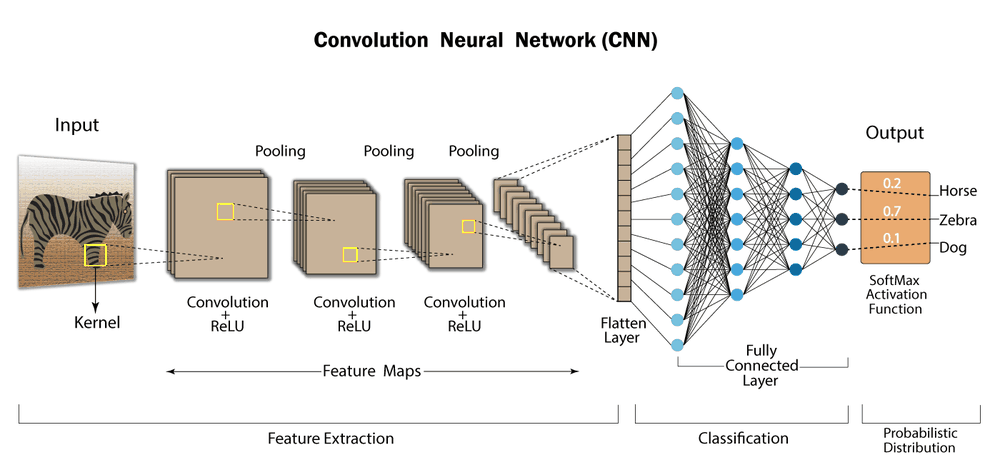
图:卷积与池化交替堆叠,空间尺寸越压越小、通道数(语义种类)越来越多,末端全连接给出分类。
两个性质是卷积的灵魂。局部连接:每个输出只看输入的一小块——图像的特征本来就是局部的,边缘、纹理都不需要看全图。参数共享:同一个核扫全图——「左上角的边缘」和「右下角的边缘」是同一个模式,没必要各学一套。这两个先验把参数量从亿级压到千级,也带来了平移不变性。
而核的内容不是人设计的。经典图像处理里有手工的 Sobel 边缘核、高斯模糊核;CNN 把这件事交给训练——第一层的核最后确实长得像各种方向的边缘检测器,但这是梯度下降自己学出来的,浅层边缘、中层纹理部件、深层语义对象的层次是涌现的。
三、池化:向下采样
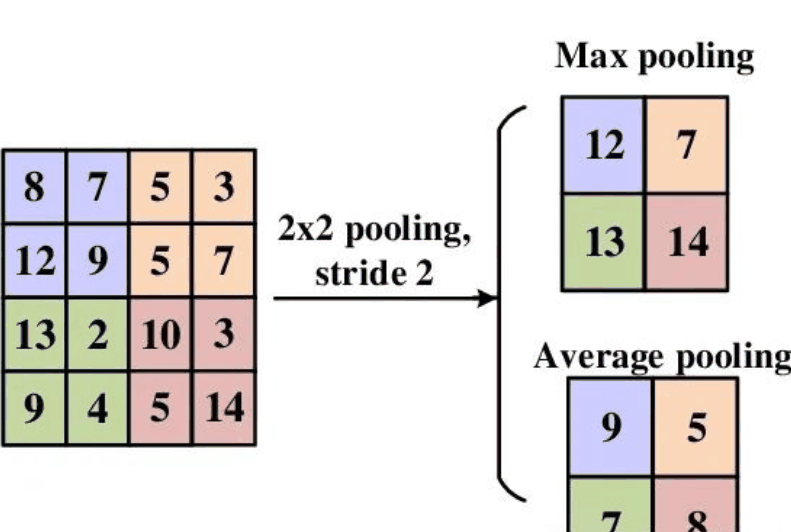
图:2×2 最大池化,每个窗口只留最大值,尺寸减半。
池化只做压缩不做学习:窗口内取最大(max pooling)或平均,图变小、信息变稠。作用有三:降低计算量、扩大后续层的等效感受野、提供小幅度平移鲁棒性。现代架构的趋势是用 stride>1 的卷积替代池化——压缩这件事卷积自己顺手就能做,还多带了一次非线性。
四、架构演进十年
| 网络 | 年份 | 贡献 |
|---|---|---|
| LeNet-5 | 1998 | 卷积+池化+全连接的完整范式,手写数字识别 |
| AlexNet | 2012 | GPU 训练 + ReLU + Dropout,ImageNet 错误率骤降,深度学习复兴的起点 |
| VGG | 2014 | 全部用 3×3 小核堆深度,证明「深而统一」就行 |
| ResNet | 2015 | 残差连接训到 152 层,见 训练:损失、优化与稳定性 |
这条主线就是「怎么把网络做深」:LeNet 定范式,AlexNet 证明规模有效,VGG 统一块形状,ResNet 拆掉退化障碍。往后的发展转向效率:MobileNet 把标准卷积拆成逐通道+逐点两步(深度可分离卷积),计算量降近一个数量级,端侧部署的常客;EfficientNet 用神经架构搜索同时缩放深度/宽度/分辨率。
💡 读老论文的 ImageNet 数字时注意口径:经典论文报的是 Top-5 错误率(正确答案不在模型前五个猜测里才算错),当前文献与产品语境默认 Top-1。Top-5 ≈ 15% 的模型,Top-1 往往在 35% 上下——直接对比两套口径会得出「早年模型已超人类」的假象。
分类之外的两个方向各用一句话定位:目标检测找「哪里有什么」——YOLO 把它做到单次前向的实时速度,DETR 则把检测变成集合预测塞进 transformer;语义分割给每个像素贴标签,U-Net 的编码器-解码器 + 跳连结构至今仍是医学影像等领域的基线。
五、ViT:图像也走 token 路线
Vision Transformer(2020)的问题意识很简单:NLP 那边 transformer 赢了,图像能不能直接用?做法:
- 图像切成 的 patch(224×224 → 196 块);
- 每块拉平、线性投影成一个向量——一个 patch 就是一个 token;
- 加位置编码(切坏了空间顺序,要补回来);
- 进标准 transformer 编码器,cls token 的输出接分类头。
实现上第 1–2 步恰好等价于一个 kernel=stride=16 的大卷积——ViT 不是抛弃卷积,是只用卷积做一次切块,把后续全部建模交给注意力。
代价与回报都来自同一个地方:卷积带着局部性、共享这两条先验,注意力不带。先验少了,模型更通用,但要数据喂饱——ViT 在 ImageNet-1k(128 万张)上训不过同算力 CNN,要到 JFT-300M 这种三亿张级别的私有序列数据上才反超。数据不够时先验是免费午餐,数据够多时先验是天花板。两边的对比:
| CNN | ViT | |
|---|---|---|
| 归纳偏置 | 局部 + 平移共享(天生适合图像) | 几乎没有(更依赖数据) |
| 感受野 | 堆层才扩大 | 第一层就是全局 |
| 数据效率 | 小数据也能训 | 大数据才发力 |
| 与 LLM 的关系 | 异构 | 同构:同一套 transformer 栈 |
最后一行是深远的那条:图像与文本从此可以用同一架构、同一套训练方法处理——多模态大模型的工程地基是 ViT 打的,见 多模态模型。
六、后续:层次化与自监督
ViT 的全局注意力对高分辨率图像太贵(,见 自注意力与 Transformer),Swin Transformer 把窗口引入层次结构——先在小窗口内做注意力、逐层合并窗口扩大感受野,兼顾 CNN 的多尺度效率与 transformer 的建模力,成了检测/分割的新基线。
另一条线是自监督:DINOv2 不用任何标签,靠自蒸馏在两亿张图上预训练 ViT,得到的特征直接线性探测就能打好分类、分割、深度——「视觉的 BERT 时刻」走得比 NLP 慢,但这条路已经走通了。2024 年后图像编码器(如 SigLIP)与 LLM 的组合干脆成为多模态模型的标准前件,视觉的自监督预训练与语言侧彻底汇流。