DMA直接存储器访问详解
笔记 / 嵌入式
引言
算一笔账:串口 115200 波特率、8N1 格式,每字节 10 位,每秒约 11520 字节,CPU 每 87 μs 就被中断打断一次。一次中断从触发到返回,压栈、取向量、跑 HAL 的处理链、出栈,微秒级开销就花掉了,而真正有用的动作只有一条”把寄存器的值存进数组”。波特率再往上、或者换成 SPI、DCMI 摄像头并口,中断频率高到 CPU 除响应中断之外无法执行其它代码。
DMA(Direct Memory Access,直接存储器访问)就是为这件事存在的:由一个独立的硬件单元在存储器和外设之间搬运数据,CPU 只负责配置与收尾。串口、SPI、I2C 各自的协议见 嵌入式通信协议UART、I2C、SPI对比详解。
一、DMA 是什么
DMA 控制器是一个独立于 CPU 的部件,和 CPU 共享同一套总线矩阵。它自己会读总线、写总线,能在存储器和外设寄存器之间直接搬运数据,全程不需要 CPU 执行指令。
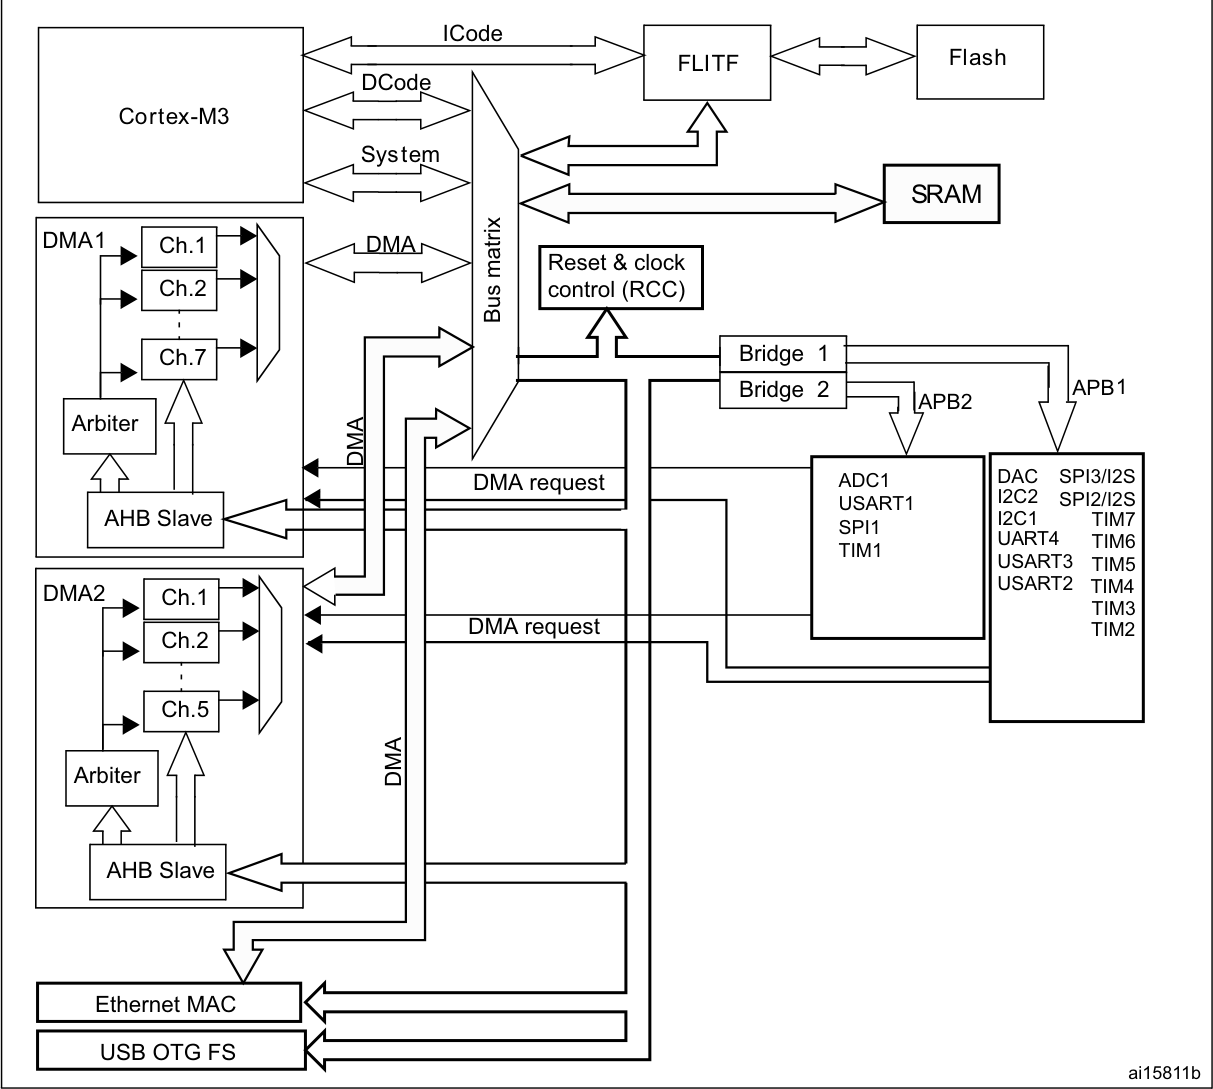
从框图能读出几个结构性事实:
- F1 有两个 DMA 控制器:DMA1 有 7 个通道,DMA2 有 5 个,但 DMA2 只在高密度、XL 密度和互联型器件上存在
- 每个 DMA 内部有仲裁器:多个通道同时申请总线时,由它决定谁先获得总线
- DMA 与 CPU 都是总线主设备,同一时刻只有一个主设备能驱动总线:DMA 搬数据时,CPU 访问同一目标(比如 SRAM)就要插入等待周期。这和多主设备系统里的总线仲裁是同一套机制。DMA 并非没有开销,只是把开销从”CPU 停下来搬”变成了”总线分时复用”
二、通道与请求映射
每个通道是独立的一套搬运逻辑:一份源地址、目标地址、计数器和控制寄存器。但 F1 的规则是固定的——通道与外设的对应关系在芯片内部已经确定,不能任意指定:SPI1 的 RX 请求只能接 DMA1 通道 2,USART1_RX 只能走 DMA1 通道 5。规划外设资源时先把映射表摆出来,两个外设落在同一通道上就要错开使用或分时使用。
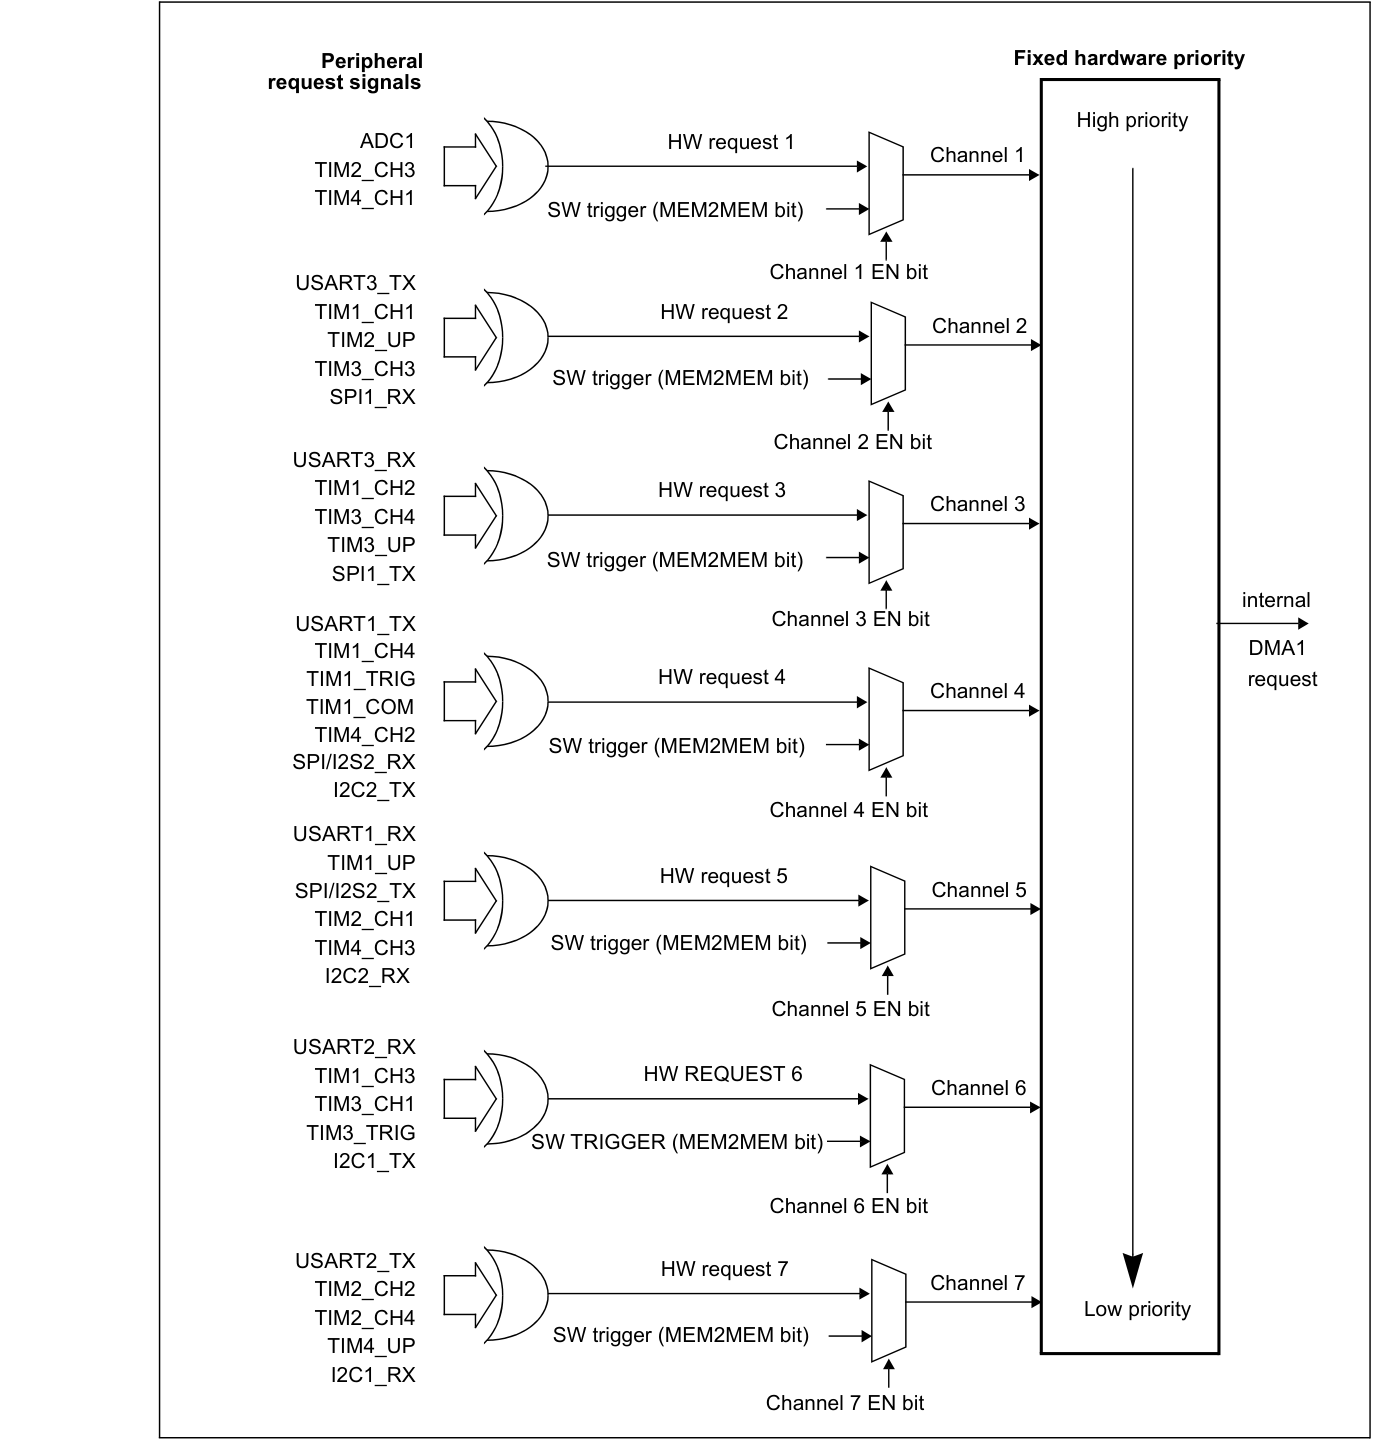
DMA1 的完整映射(整理自 RM0008 Table 78):
| 外设 | Ch1 | Ch2 | Ch3 | Ch4 | Ch5 | Ch6 | Ch7 |
|---|---|---|---|---|---|---|---|
| ADC1 | ADC1 | ||||||
| SPI/I2S | SPI1_RX | SPI1_TX | SPI2/I2S2_RX | SPI2/I2S2_TX | |||
| USART | USART3_TX | USART3_RX | USART1_TX | USART1_RX | USART2_RX | USART2_TX | |
| I2C | I2C2_TX | I2C2_RX | I2C1_TX | I2C1_RX | |||
| TIM1 | TIM1_CH1 | TIM1_CH4/TRIG/COM | TIM1_UP | TIM1_CH3 | |||
| TIM2 | TIM2_CH3 | TIM2_UP | TIM2_CH1 | TIM2_CH2/CH4 | |||
| TIM3 | TIM3_CH3 | TIM3_CH4 | TIM3_UP | TIM3_CH1/TRIG | |||
| TIM4 | TIM4_CH1 | TIM4_CH2 | TIM4_CH3 | TIM4_UP |
表中 TIM3_CH1/TRIG 实际位于通道 6、I2C2 仅部分密度型号提供;DMA2 的映射(TIM7/8、ADC3、SPI3、UART4 等)见 RM0008 Figure 51。用之前对照手册确认自己这颗料的手册版本。
仲裁分两级:先比软件优先级(VeryHigh/High/Medium/Low 四档,初始化时配置),同档再比硬件优先级,通道号小的先获得总线。上图左侧从 High 到 Low 的灰度渐变,画的就是这个固定次序。
三、传输三要素
配置一次 DMA 传输,本质是填三个寄存器:
| 要素 | F1 寄存器 | 含义 |
|---|---|---|
| 外设地址 | CPAR | 数据的源头或终点(通常是外设的数据寄存器,如 &USART1->DR) |
| 内存地址 | CMAR | 另一端,指向 RAM 里的缓冲区 |
| 传输数量 | CNDTR | 还剩多少个数据单位没搬(递减计数,写 0 会触发一次 65535 的传输) |
配合两个开关决定地址是否递增:
- PINC(外设地址递增):收发数据寄存器地址固定,通常关闭
- MINC(内存地址递增):缓冲区地址逐单位前进,通常开启
三要素组合出四种传输方向:
| 方向 | 典型场景 | PINC/MINC |
|---|---|---|
| 外设 → 内存 | ADC 采样入数组、串口收包 | 0 / 1 |
| 内存 → 外设 | 串口发一串数据、DAC 播放波形 | 1 / 0 |
| 内存 → 内存 | 大块缓冲区拷贝(需开 MEM2MEM 软件触发) | 1 / 1 |
| 外设 → 外设 | 极少用 | 0 / 0 |
内存到内存模式没有硬件请求源,靠软件置位 MEM2MEM 启动,并且会一直占用该通道直到搬完,期间不能承担其它传输。大块拷贝用它,零散拷贝用 memcpy 更合适。
四、两种工作模式
| 模式 | 行为 | 适用 |
|---|---|---|
| Normal(正常) | 搬完 CNDTR 个数据后停下,需重新使能 | 发一段、收一包这种一次性传输 |
| Circular(循环) | 搬完后地址自动回卷到起点,永不停止 | ADC 持续采集、串口空闲中断配 DMA 收不定长帧 |
循环模式配**半传输中断(HT)**是常用做法:把缓冲区分成两半,DMA 搬满前一半时触发 HT 中断处理前一半,搬满整块时触发 TC 中断处理后一半,采集与处理交替进行,缓冲区不会溢出。ADC模数转换详解 第五节的多通道采集用的就是这个方案。
F1 没有双缓冲(double buffer)模式,这是 F4 起才有的硬件特性:两块缓冲区交替使用,切换时由硬件自动更换地址。F1 要实现类似效果,需要在 HT/TC 中断里手动切换。
五、HAL 配置示例:串口 DMA 发送
以 USART1_TX(DMA1 通道 4)发送一段数据为例,对照三要素看:
// 1. 时钟:DMA1 和 USART1 挂的桥都要开
__HAL_RCC_DMA1_CLK_ENABLE();
__HAL_RCC_USART1_CLK_ENABLE();

// 2. 配置通道,三要素就是这三个成员
DMA_HandleTypeDef hdma_usart1_tx = {0};
hdma_usart1_tx.Instance = DMA1_Channel4;                  // 查映射表:USART1_TX 固定在 Ch4
hdma_usart1_tx.Init.Direction = DMA_MEMORY_TO_PERIPH;     // 内存 → 外设
hdma_usart1_tx.Init.PeriphInc = DMA_PINC_DISABLE;         // 发送寄存器地址固定
hdma_usart1_tx.Init.MemInc = DMA_MINC_ENABLE;             // 内存逐字节前进
hdma_usart1_tx.Init.PeriphDataAlignment = DMA_PDATAALIGN_BYTE;
hdma_usart1_tx.Init.MemDataAlignment = DMA_MDATAALIGN_BYTE;
hdma_usart1_tx.Init.Mode = DMA_NORMAL;                    // 发完即止
hdma_usart1_tx.Init.Priority = DMA_PRIORITY_MEDIUM;
HAL_DMA_Init(&hdma_usart1_tx);

// 3. 把通道挂到串口上(CubeMX 生成的代码就是这句的展开)
__HAL_LINKDMA(&huart1, hdmatx, hdma_usart1_tx);

// 4. 启动:配置完成后发起传输,其余由 DMA 完成
HAL_UART_Transmit_DMA(&huart1, (uint8_t *)"hello", 5);
// 函数立即返回,CPU 继续执行其它代码;搬完触发 TC 中断,HAL 回调 HAL_UART_TxCpltCallback()
接收方向把 Direction 换成 DMA_PERIPH_TO_MEMORY、通道换成 5(USART1_RX)、模式按需改 DMA_CIRCULAR 即可。实际工程里更常用的是串口空闲中断(IDLE)+ DMA 循环接收收不定长帧:DMA 持续搬运,串口线路一空闲就触发 IDLE 中断,在中断里用”缓冲区长度 − CNDTR 剩余值”算出本帧实际长度。
六、常见问题与注意事项
| 问题 | 原因 | 解决 |
|---|---|---|
| DMA 无任何反应 | DMA 时钟未开,或通道选错(外设与通道是固定绑定) | 对照第二节映射表检查 |
| 只能传输一次,第二次不执行 | Normal 模式搬完 CNDTR 归零后通道停止 | 每次传输前重写 CNDTR 并重新使能;或改用循环模式 |
| 收到的数据滞后 | CPU 带 cache 时(H7),DMA 写的是物理内存,CPU 读的是 cache 行 | 缓冲区放非缓存区,或传输前后做 cache invalidate/clean |
| HAL 回调没进 | 未使能对应中断,或 NVIC 里没给 DMA 通道开中断线 | HAL_NVIC_EnableIRQ(DMA1_Channel4_IRQn) |
| 传输中途改缓冲区出错 | CPU 与 DMA 并发访问同一块内存 | 在 HT/TC 中断里切换,天然分时 |
| M2M 传输结束后通道停止 | MEM2MEM 模式搬完即停,属正常行为 | 重新装载配置再启动 |
另外两点工程注意:
- DMA 并非没有开销:高频小包传输里 DMA 请求同样要占用总线矩阵,与 CPU 相互拖慢。数据量不大时,中断方式反而更简单
- F1 的通道没有 FIFO、不支持突发传输,一个数据一次请求;F4 起每流有 4 字宽 FIFO 和 4 节拍突发,吞吐上限不同
七、各系列 DMA 速查
| 指标 | STM32F1 | STM32F4 | STM32H7 |
|---|---|---|---|
| 控制器 | DMA1×7 通道 + DMA2×5 通道 | DMA1/DMA2 各 8 流 | MDMA + DMA1/DMA2 各 8 流 |
| 请求映射 | 固定绑定 | 固定绑定 | DMAMUX 任意路由 |
| FIFO/突发 | 无 | 4 字 FIFO、支持突发 | 有 |
| 双缓冲 | 无 | 有 | 有 |
F1 到 F4 是量变(FIFO、双缓冲、更多流),F4 到 H7 是质变:DMAMUX 相当于一个可编程的多路选择器,任意请求都能路由到任意通道,解除了 F1 时代最大的资源规划限制。
总结
DMA 由独立控制器完成存储器与外设之间的数据搬运,CPU 只负责配置和收尾。理解三要素(源、目的、数量)、两种模式(正常、循环)和那张固定映射表,F1 上的 DMA 行为就完全清楚了。搬运完成的中断回调里可以放置信号量唤醒任务(见 FreeRTOS信号量与回调函数),实现中断到任务的数据交接。